Inteligência artificial · caderno de investigação
De 20 configurações para 4: um roteador de GPT enxuto
Uma análise de vinte combinações de Luna, Terra, Sol e Astra para construir um roteador simples que escala apenas quando a tarefa exige.
Neste artigo
Vinte combinações de modelo e nível de raciocínio parecem oferecer liberdade de escolha. Quando coloco qualidade e custo por tarefa no mesmo mapa, encontro uma escada bem mais simples: quatro configurações cobrem os principais degraus sem transformar o roteador em um catálogo de exceções.
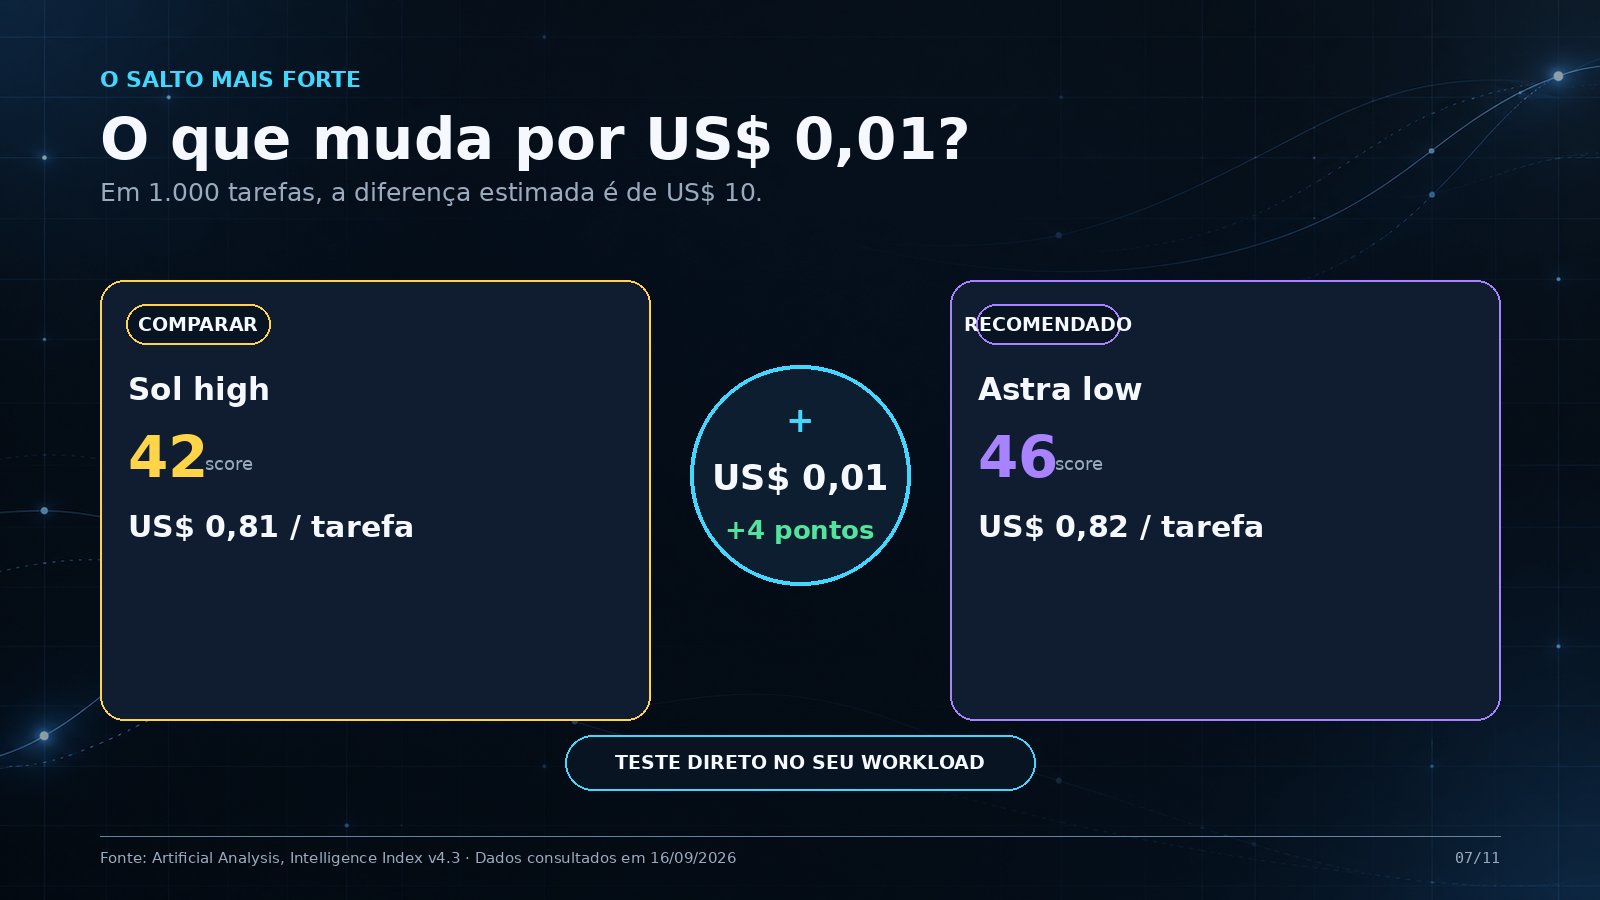
Sol high custa US$ 0,81 por tarefa no recorte analisado. Astra low custa US$ 0,82. Por um centavo a mais, o score exibido no Intelligence Index da Artificial Analysis passa de 42 para 46. Esse centavo resume o problema de escolher modelos apenas pelo nome ou pelo preço de cada token.
A pergunta que realmente ajuda a projetar um sistema é: qual é o próximo ganho de qualidade que vale pagar para esta tarefa?
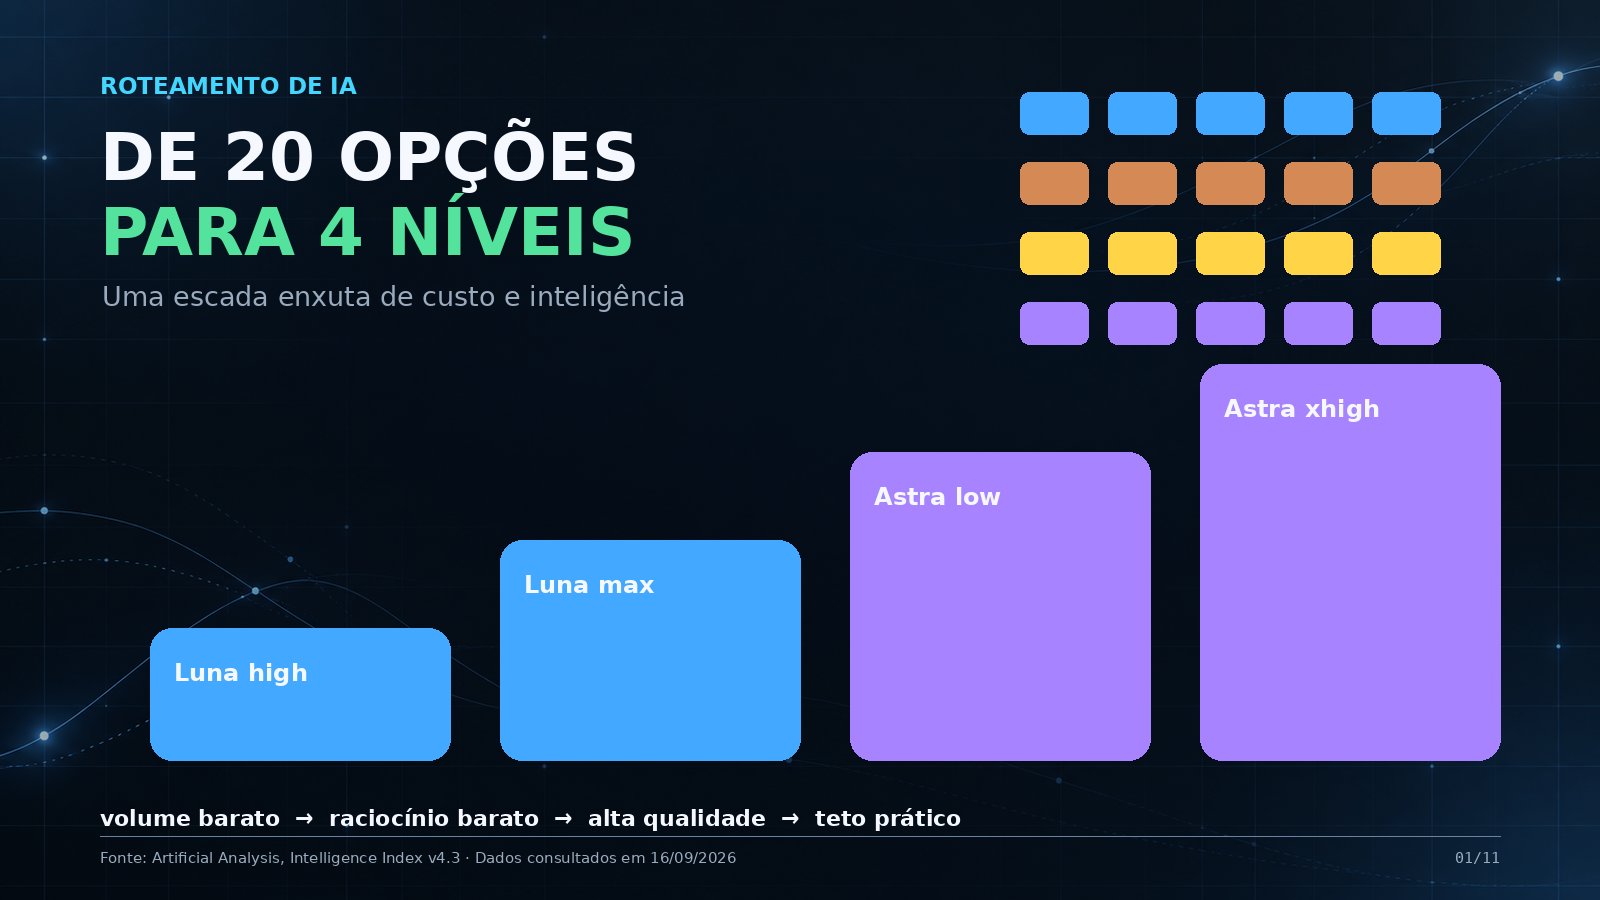
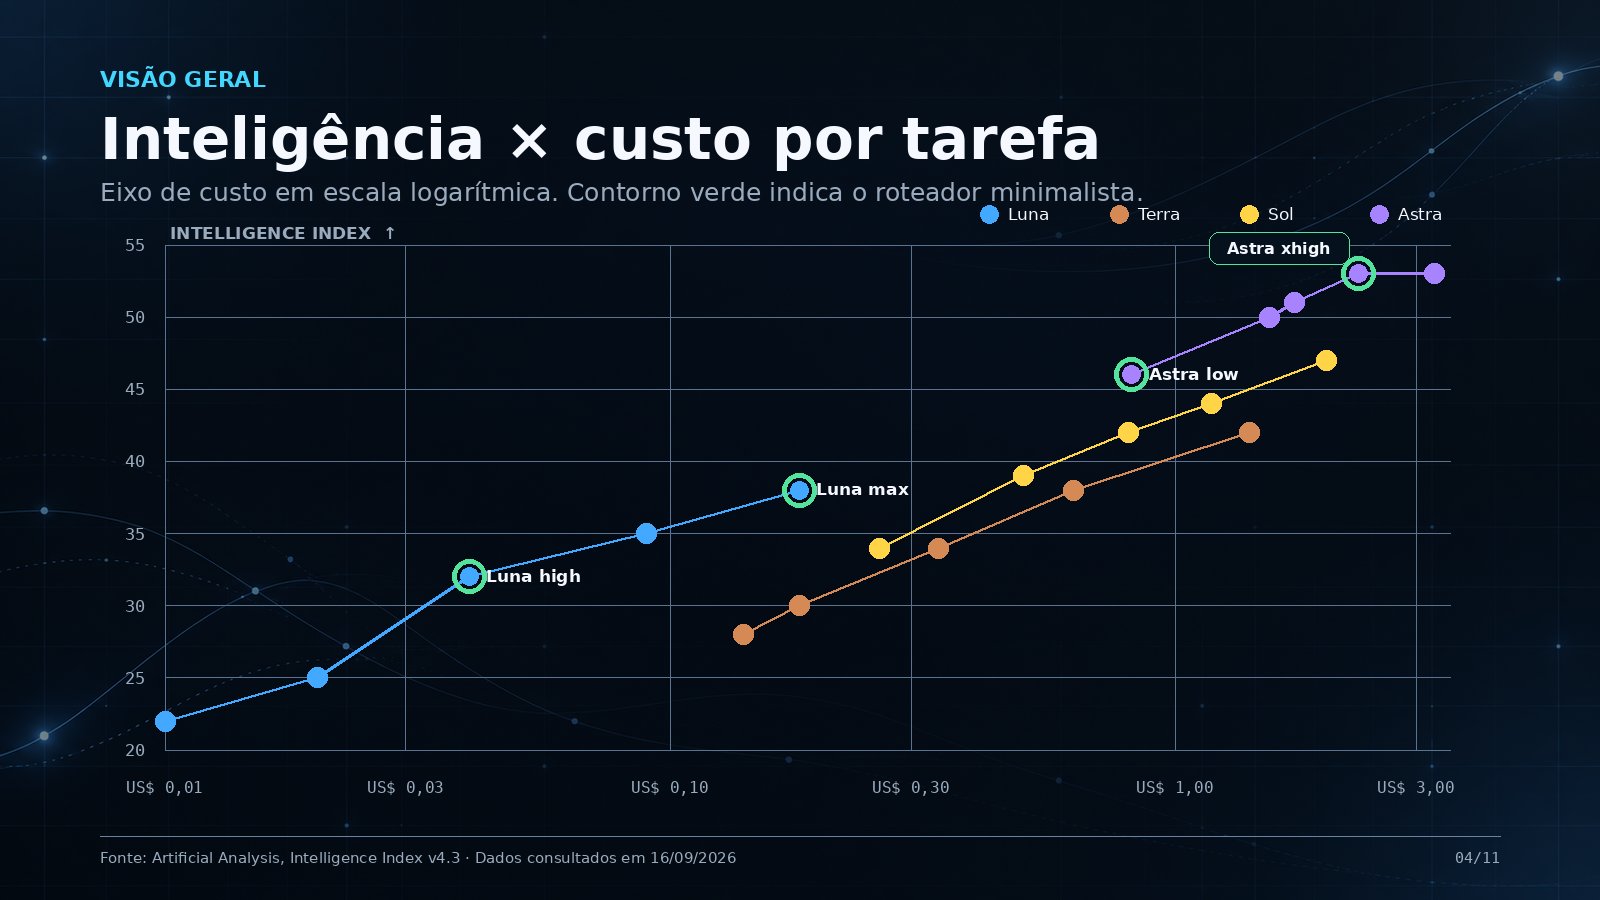
Comparei 20 combinações entre GPT-5.6 Luna, Terra, Sol e GPT-6 Astra, cada uma com cinco níveis de raciocínio. Minha proposta para um roteador enxuto é Luna high → Luna max → Astra low → Astra xhigh. Sol medium pode entrar se os testes do seu produto mostrarem que ele resolve uma faixa intermediária real.
A escolha real é modelo mais nível de raciocínio
Cada família oferece configurações como low, medium, high, xhigh e max. O nível de raciocínio, ou effort, controla quanto trabalho o modelo pode dedicar antes de responder. Subir de nível costuma consumir mais tokens, aumentar o tempo e elevar o custo. A qualidade também pode melhorar, mas nem sempre na mesma proporção.
Por isso, perguntar “qual GPT devo usar?” ainda deixa uma decisão importante de fora. Para encaminhar uma tarefa, a unidade prática é família + effort. Classificar um ticket simples, extrair campos de um documento e investigar uma falha complexa não precisam começar no mesmo degrau.
Preço por token não é custo por tarefa
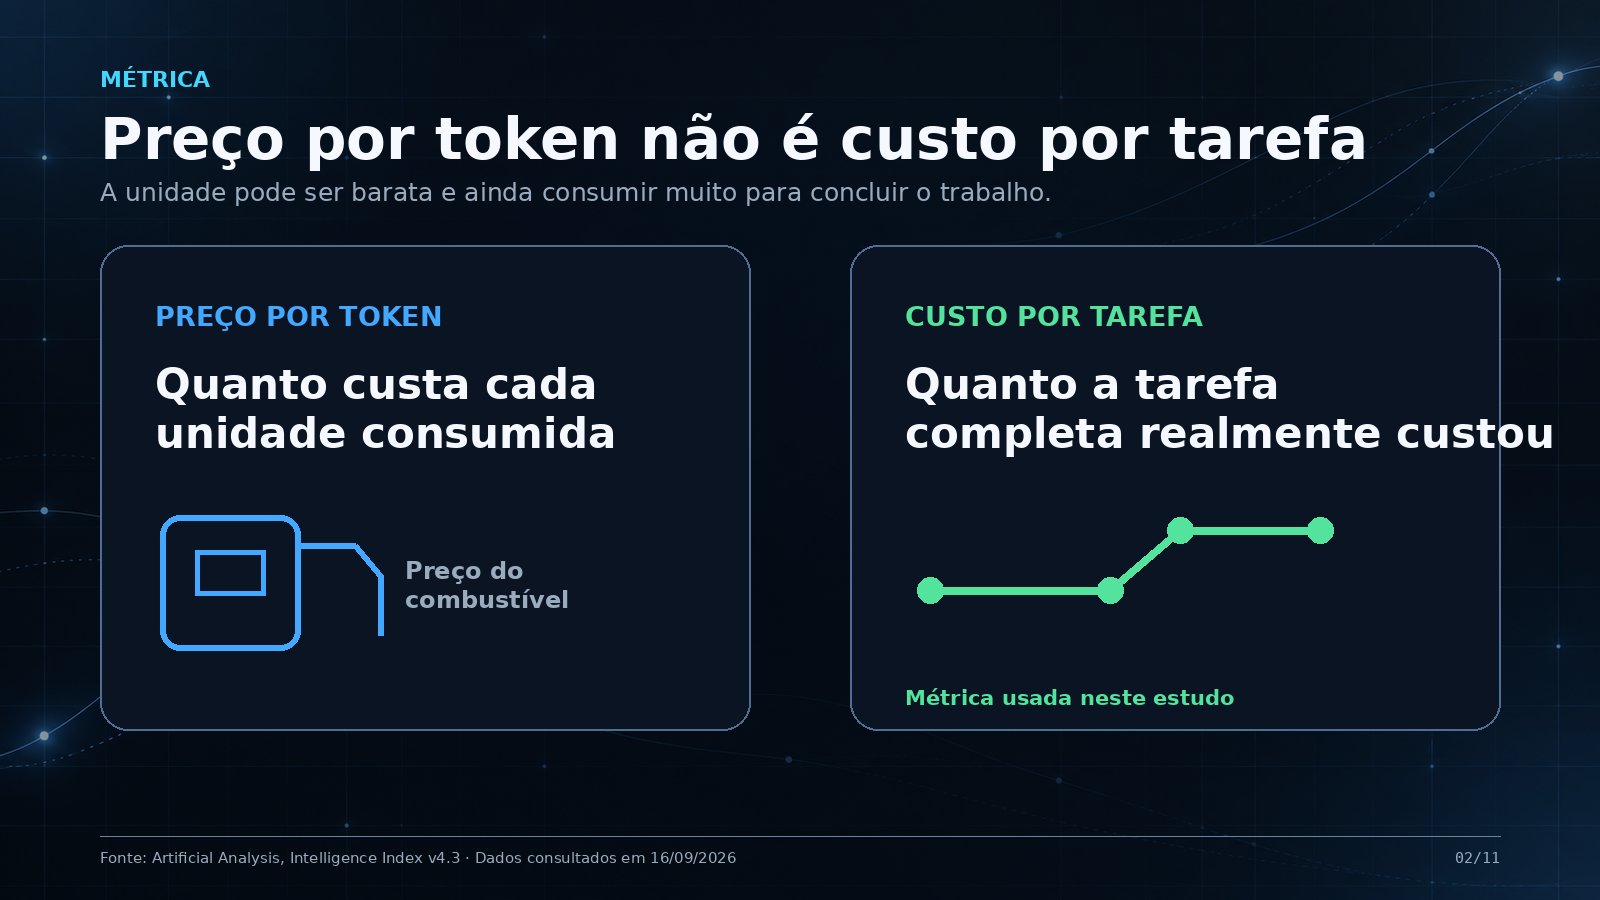
A tarifa por milhão de tokens informa quanto cada unidade custa. Ela não diz quantos tokens serão gastos até a resposta. Um modelo barato por token pode raciocinar por mais tempo e terminar com uma tarefa cara. Dois efforts da mesma família podem ter a mesma tarifa e custos finais muito diferentes.
Usei o Cost per Intelligence Index Task da Artificial Analysis. A métrica pondera o custo de entrada, cache, raciocínio e resposta nas tarefas do índice. Ela é mais útil para comparar configurações do que a tarifa isolada, embora não seja uma previsão da sua fatura.
Primeiro corte: a fronteira de Pareto
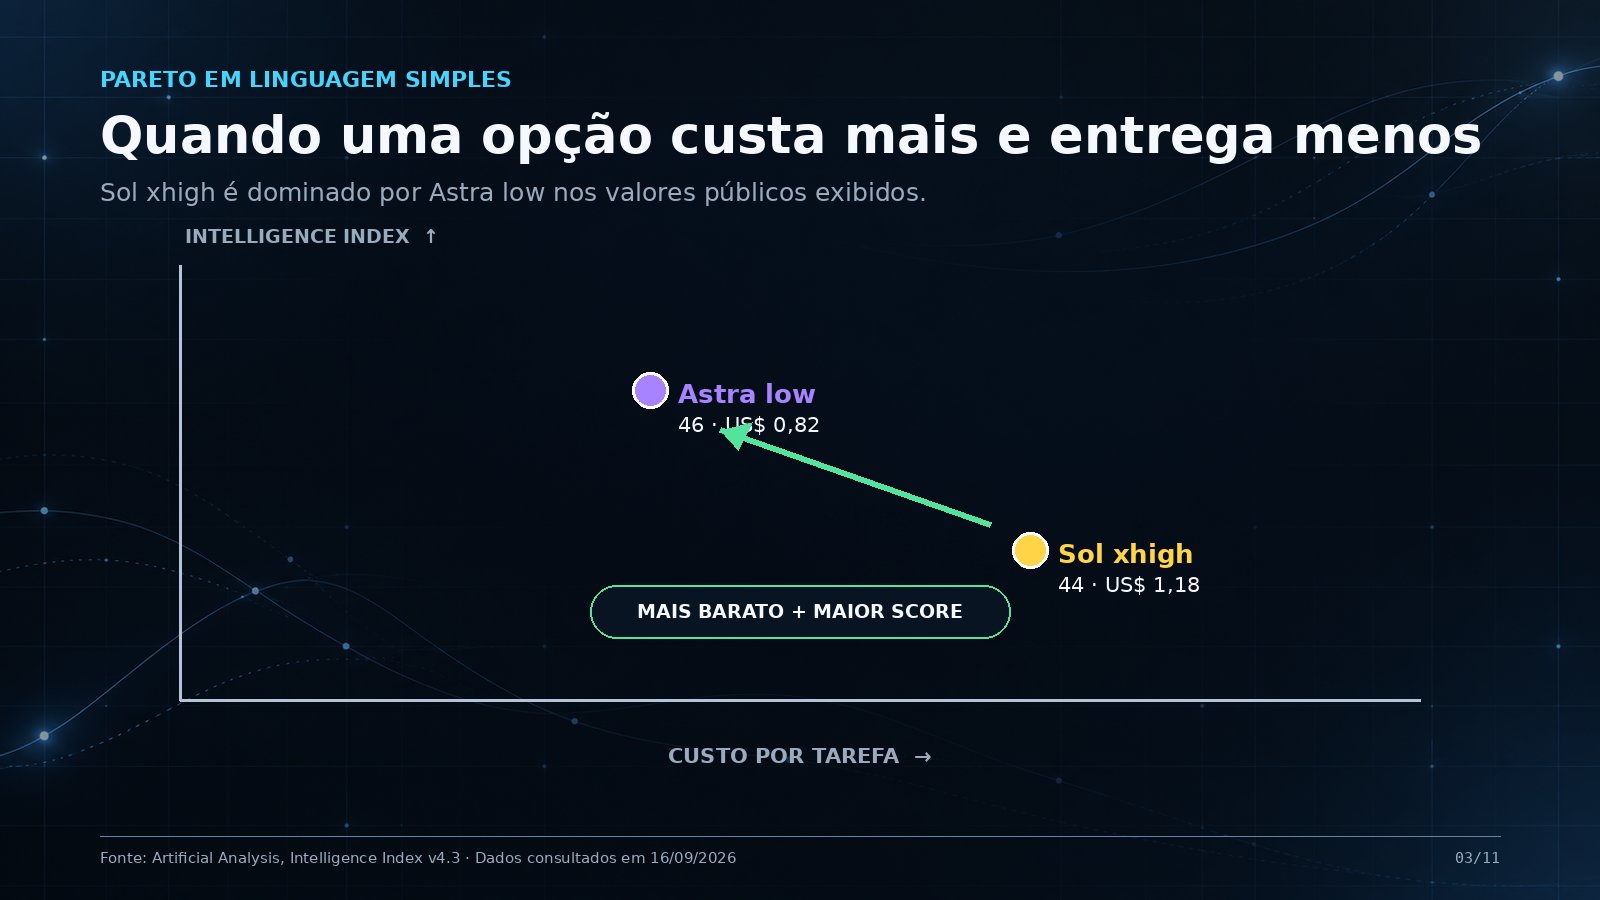
Uma configuração é dominada quando outra custa menos ou igual e entrega score maior ou igual, com vantagem real em pelo menos uma dessas medidas. Nesse par de critérios, não existe motivo para escolhê-la. A fronteira de Pareto reúne as alternativas que sobrevivem a essa comparação.
Veja Sol xhigh: score 44 por US$ 1,18. Astra low aparece com score 46 por US$ 0,82. Nos números exibidos, Astra low é melhor nas duas dimensões.
Mas sobreviver à fronteira matemática não significa merecer uma regra no sistema. Uma configuração pode acrescentar um ponto de score, custar bem mais e exigir outro conjunto de testes, monitoramento e decisões. Fiz, portanto, dois cortes: eliminei os pontos dominados e depois retirei degraus que pouco acrescentavam à operação.
No mapa completo, Luna ocupa a zona econômica, Astra concentra os scores mais altos, e Terra e Sol disputam o meio. O intervalo vai de cerca de US$ 0,01 a US$ 3,26 por tarefa; a escala logarítmica mantém as vinte opções legíveis.
Luna: dois degraus econômicos que têm funções diferentes
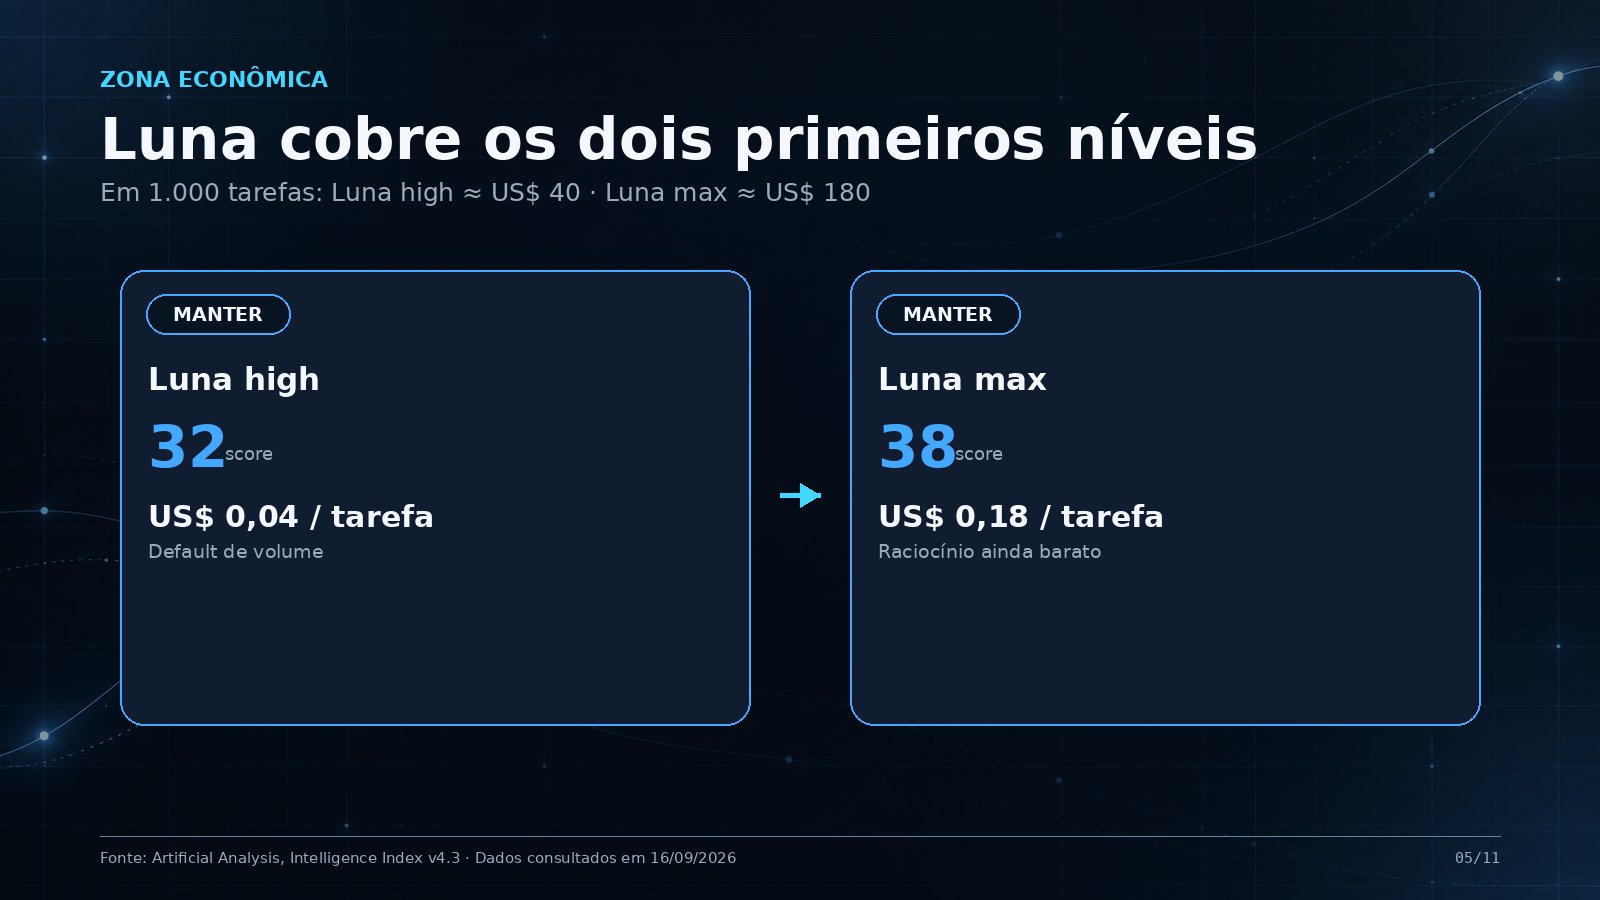
No recorte, Luna high entrega score 32 por US$ 0,04. É um bom ponto inicial para volume alto, classificação, extração e tarefas com critérios claros. Luna max sobe para 38 por US$ 0,18 e atende casos que precisam de mais raciocínio sem entrar na faixa premium.
Luna xhigh, com 35 por US$ 0,09, também é eficiente. Não saiu da seleção por ser ruim: high e max simplesmente formam uma escada mais fácil de explicar e operar. Os níveis low e medium podem ser úteis quando volumes enormes tornam cada fração de centavo relevante; para um roteador generalista, high oferece um início mais capaz.
Terra: redundante no critério analisado
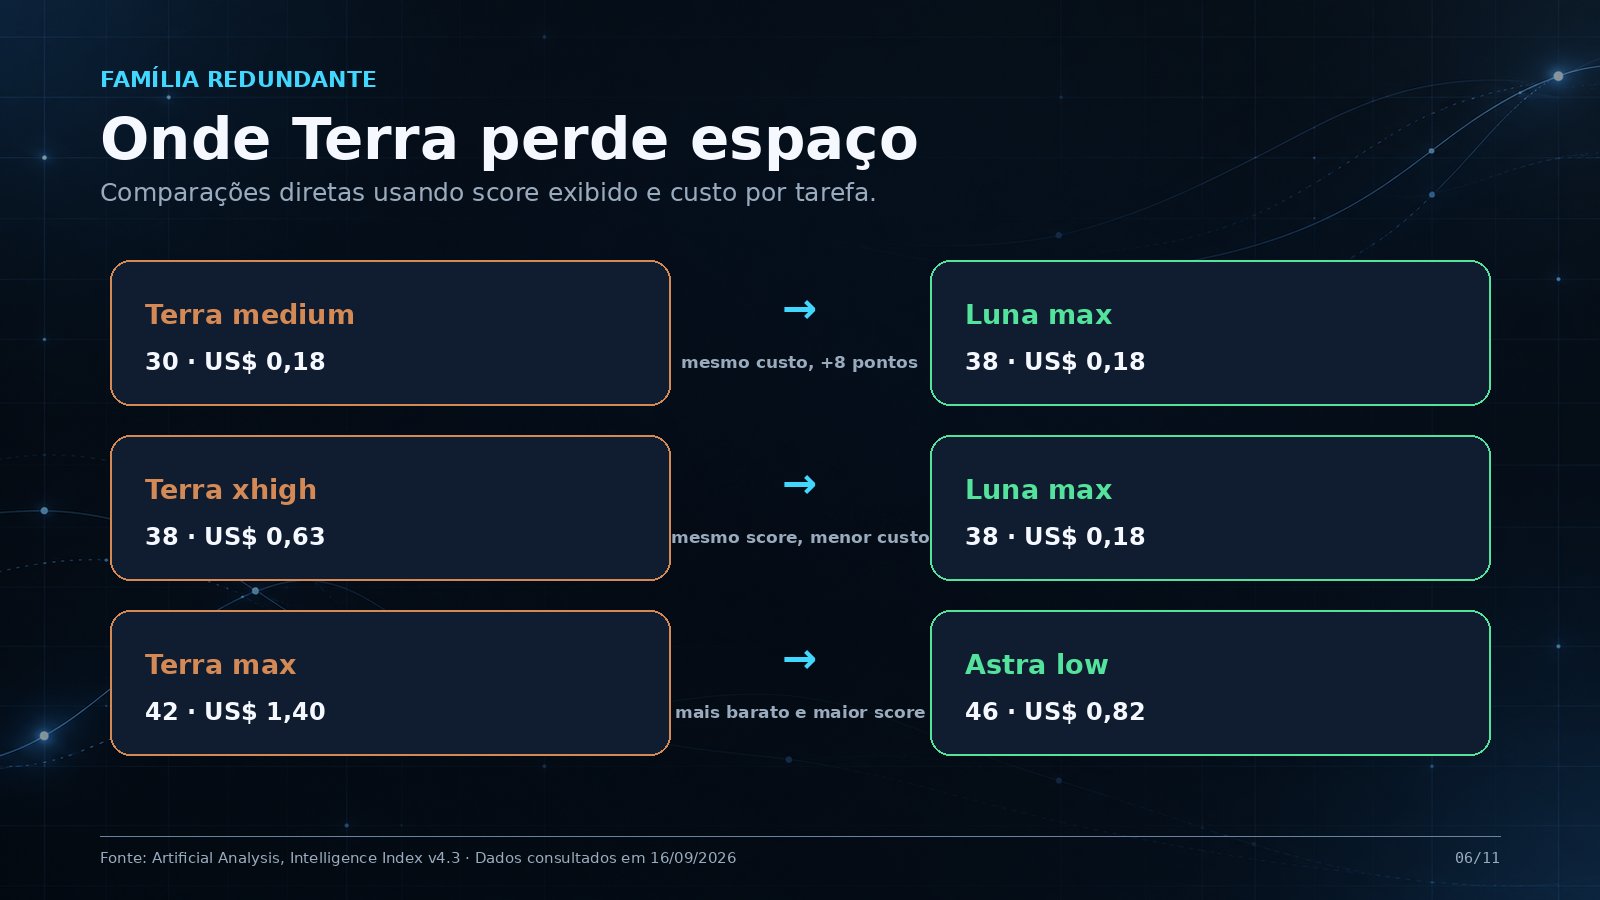
Terra perde espaço quando comparado com todas as famílias, e não apenas com seus próprios efforts. Três exemplos deixam a diferença visível:
| Configuração Terra | Score · custo por tarefa | Alternativa no recorte | Score · custo por tarefa |
|---|---|---|---|
| Terra medium | 30 · US$ 0,18 | Luna max | 38 · US$ 0,18 |
| Terra xhigh | 38 · US$ 0,63 | Luna max | 38 · US$ 0,18 |
| Terra max | 42 · US$ 1,40 | Astra low | 46 · US$ 0,82 |
A análise comparativa da Artificial Analysis chega à mesma leitura: Luna e Sol ficam à frente de Terra na relação entre inteligência e custo. Assim, Terra não abre uma região atraente nessas duas métricas.
Isso não prova que Terra seja inútil. Compatibilidade, disponibilidade, latência ou desempenho no seu domínio podem justificar sua presença. Se houver esse motivo, ele precisa ser medido separadamente.
Sol: um centavo muda o meio da escada
Sol compete melhor que Terra, mas Astra comprime seu espaço. Sol high marca 42 por US$ 0,81; Astra low, 46 por US$ 0,82. Sol high não é estritamente dominado, pois custa um centavo a menos. Operacionalmente, esse centavo dificilmente paga uma regra adicional no roteador.
Nos níveis superiores, a comparação é mais clara:
| Sol | Score · custo | Astra | Score · custo |
|---|---|---|---|
| Sol xhigh | 44 · US$ 1,18 | Astra low | 46 · US$ 0,82 |
| Sol max | 47 · US$ 1,99 | Astra medium | 50 · US$ 1,54 |
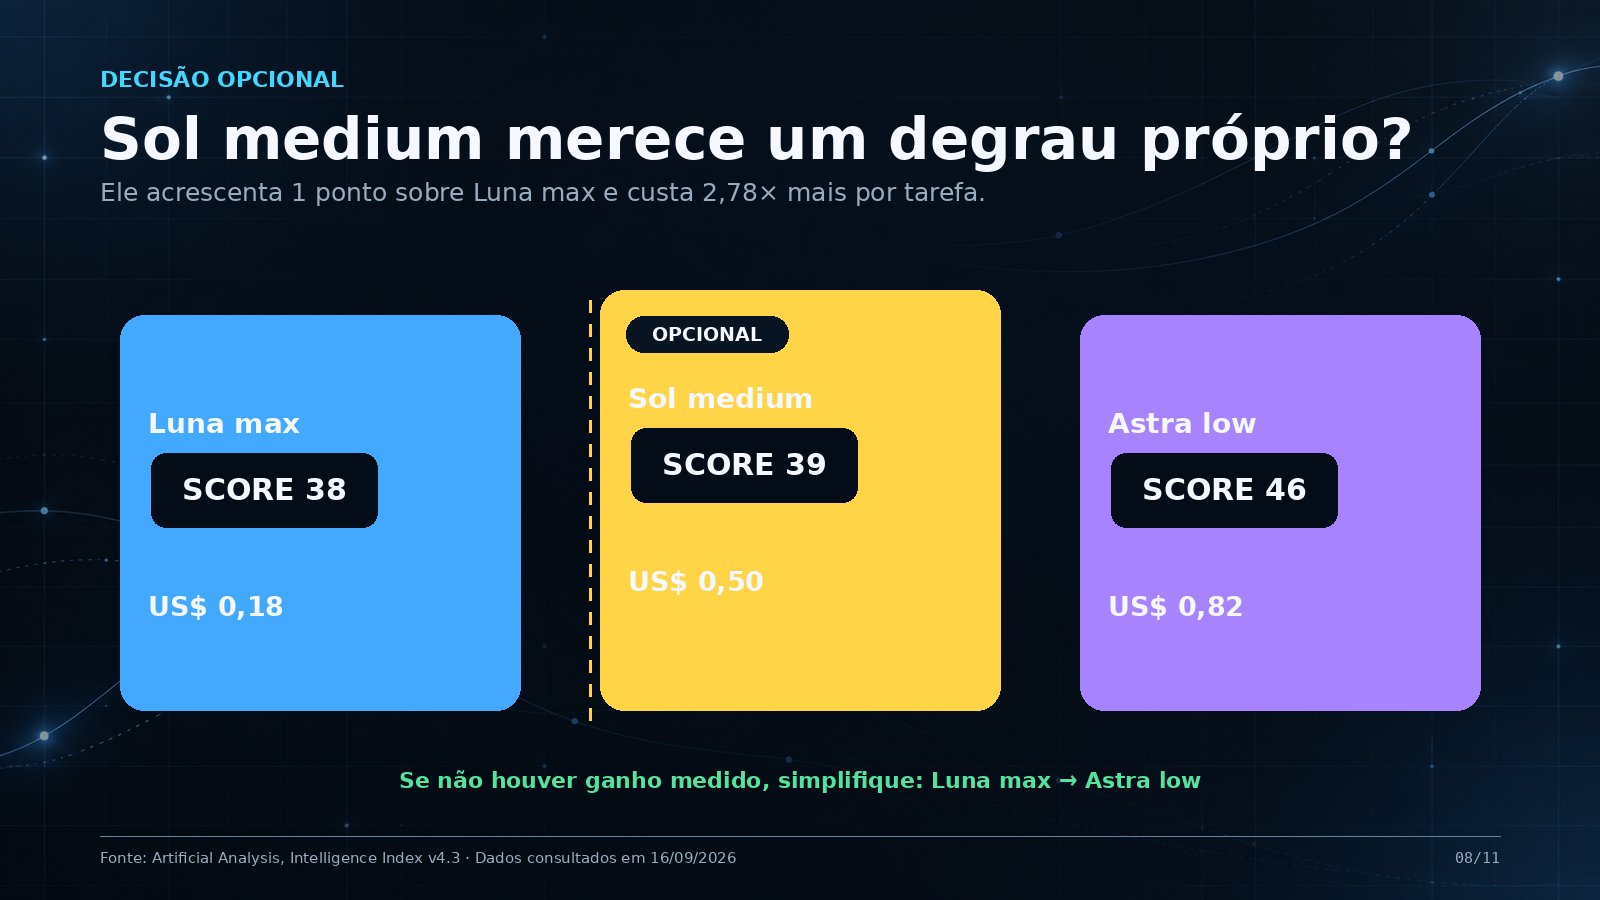
O melhor argumento para manter Sol é medium: score 39 por US$ 0,50. Ele fica entre Luna max (38 por US$ 0,18) e Astra low (46 por US$ 0,82). A transição pode ser útil se Luna max falhar em tarefas que ainda não exigem Astra low. Nos dados do índice, porém, o ganho sobre Luna max é de apenas um ponto por quase 2,8 vezes o custo.
Minha regra seria incluir Sol medium apenas depois de medir esse ganho em casos reais. Sem essa evidência, ele é um degrau opcional.
Astra: entrada premium e teto prático
Astra low chega a score 46 por US$ 0,82 e se torna a entrada natural para trabalho importante, difícil ou com maior custo de erro. Astra xhigh aparece com 53 por US$ 2,31: é o teto prático da minha seleção, quando qualidade vale mais que custo.
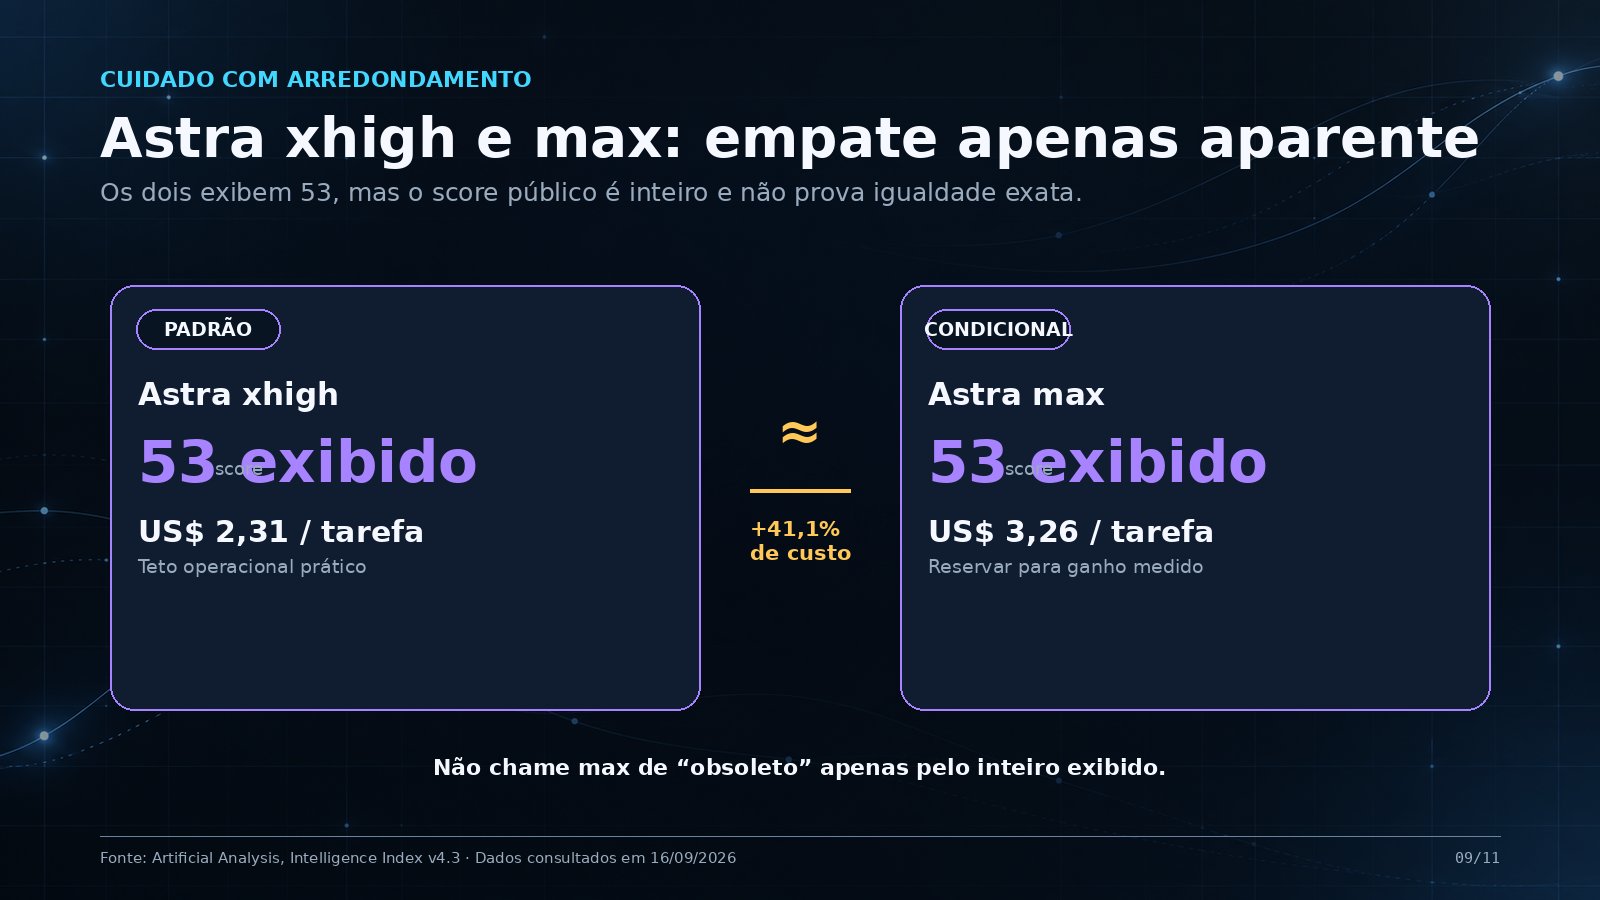
Astra max também mostra 53, mas por US$ 3,26. Não dá para concluir que xhigh é igual e apenas mais barato: o score público é arredondado, e a Artificial Analysis afirma que todos os efforts do Astra permanecem na fronteira. Medium e high também são válidos ali. Eu os retiro da escada principal para simplificar a operação, não por inferioridade matemática.
Max deve virar padrão somente se testes próprios identificarem um ganho que compense o prêmio. O mesmo raciocínio vale para adicionar qualquer outro degrau.
O roteador final cabe em quatro regras
| Nível | Score no recorte | Custo por tarefa | Papel no sistema |
|---|---|---|---|
| Luna high | 32 | US$ 0,04 | Volume, classificação, extração e tarefas claras |
| Luna max | 38 | US$ 0,18 | Mais raciocínio ainda na faixa econômica |
| Astra low | 46 | US$ 0,82 | Casos difíceis ou com maior custo de erro |
| Astra xhigh | 53 | US$ 2,31 | Exceções críticas em que qualidade é prioridade |
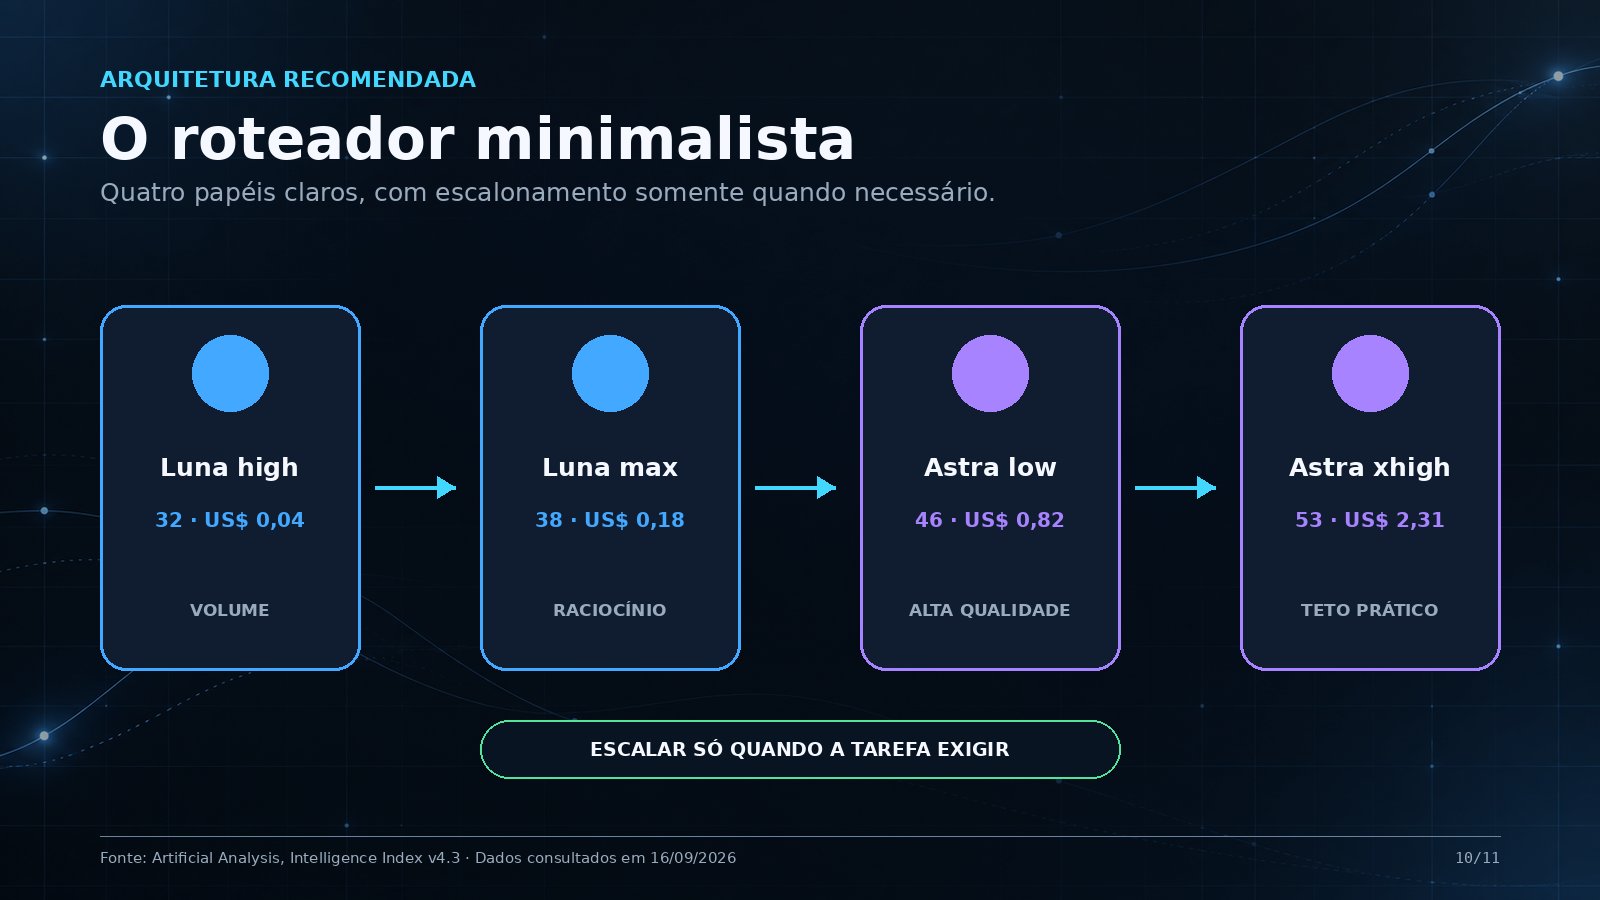
O sistema não precisa adivinhar perfeitamente a dificuldade antes de executar. Pode começar no menor nível compatível, validar formato e critérios de qualidade, subir quando a resposta falhar e registrar quais tipos de tarefa exigiram escalada.
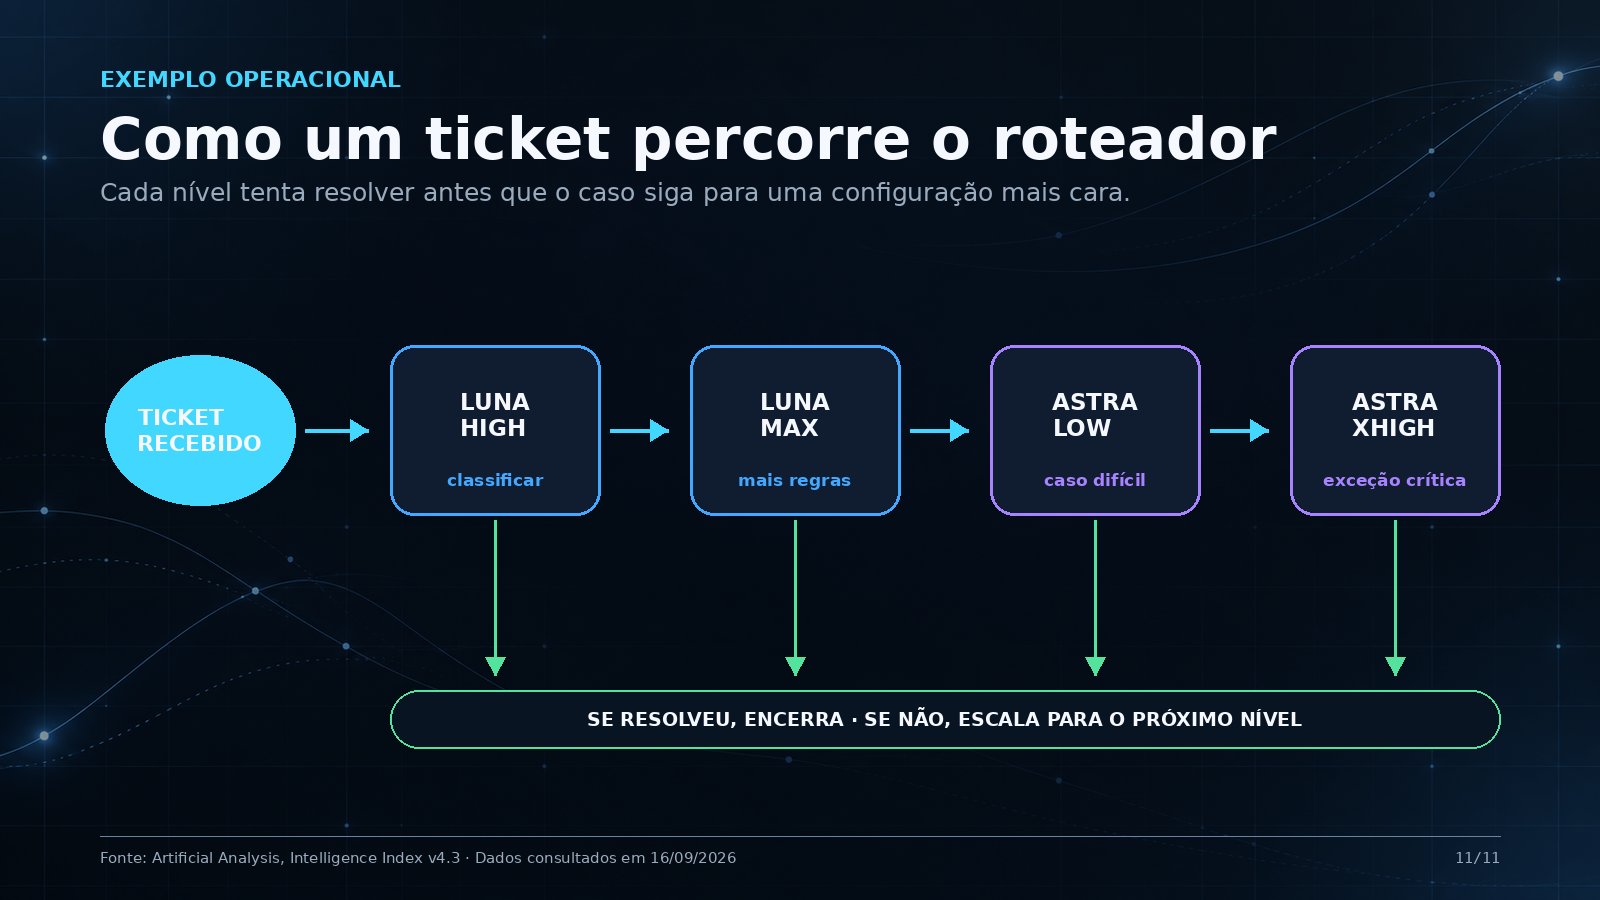
Num ticket de suporte, por exemplo, Luna high pode tentar classificar e extrair dados; Luna max entra se houver mais regras e ambiguidade; Astra low analisa um caso difícil; xhigh fica para a exceção crítica. Se uma etapa resolve o caso, o fluxo termina ali.
O benchmark mostra o mapa; seus dados escolhem a rota
O Intelligence Index combina avaliações de conhecimento, automação, terminal, código, documentos profissionais e contexto longo. É mais informativo do que um teste isolado, mas não responde sozinho qual configuração respeita melhor o seu formato, usa ferramentas com mais sucesso, entende seu domínio, entrega latência aceitável e mantém estabilidade.
O próprio Astra ilustra essa nuance: mesmo avançando no índice agregado, a avaliação publicada aponta áreas em que a comparação com Sol é menos favorável. Score maior não significa melhor em todas as tarefas.
Use o benchmark para reduzir de vinte candidatos a quatro. Depois, rode seus casos reais e registre qualidade, custo, latência, taxa de erro e taxa de escalada. A seleção final pode terminar com três níveis ou cinco. O ganho já aparece quando cada opção tem um papel claro e medido.
 Inteligência artificial
 Inteligência artificial