Inteligência artificial · caderno de investigação
Seu computador de 2029 poderá rodar a melhor IA de 2026?
O que memória, quantização, modelos especialistas e avanços de hardware indicam sobre a chance de usar uma IA de fronteira em casa até 2029.
Neste artigo
A chance de um computador pessoal reproduzir boa parte da utilidade dos melhores modelos de IA de 2026 até 2029 é maior do que o tamanho dos modelos atuais sugere. O caminho passa por memória, algoritmos, modelos especializados e pela forma como organizamos o sistema inteiro.
Em setembro de 2026, modelos de fronteira como GPT-6 Astra e Claude Fable 5.1 vivem em centros de dados. Nós os alugamos por token. A pergunta interessante é: quanto hardware será necessário, em 2029, para repetir a utilidade que parecia extraordinária em 2026? É uma meta fixa; perguntar se o melhor modelo de 2029 caberá num PC de 2029 significa perseguir um alvo que também avança.
A conta começa pela pergunta certa
Comparar o total de parâmetros de um modelo com a RAM disponível é uma aproximação ruim por cinco motivos:
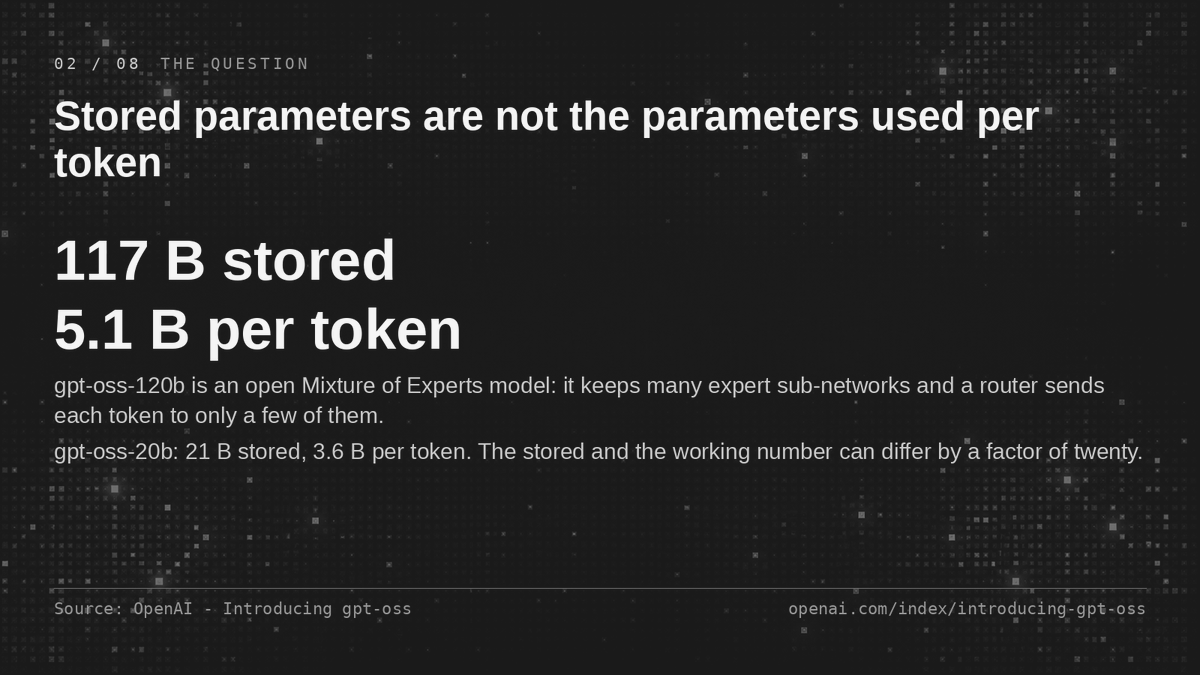
Parâmetros armazenados não são necessariamente usados a cada token. Em uma arquitetura Mixture of Experts (MoE), um roteador ativa só alguns especialistas. O gpt-oss-120b guarda cerca de 117 bilhões de parâmetros, mas usa aproximadamente 5,1 bilhões por token. No gpt-oss-20b, a relação é de 21 bilhões para 3,6 bilhões (OpenAI).
O tamanho depende da precisão. Um peso de 16 bits ocupa quatro vezes o espaço de um peso de 4 bits. Pesos ternários, restritos a −1, 0 e +1, exigem cerca de 1,58 bit em termos teóricos.
Capacidade guardada e trabalho feito são coisas diferentes. Um modelo pode armazenar muito conhecimento e gastar pouco cálculo em cada resposta.
Treinamento posterior e tempo de raciocínio mudam o resultado. Aprendizado por reforço, destilação e verificação podem elevar a qualidade sem aumentar o número de pesos.
A experiência é produzida por um sistema. Busca, execução de código, memória, recuperação de documentos, ferramentas e verificadores também fazem parte da utilidade percebida.
O que significa “tão inteligente quanto Astra”?
Não existe uma única nota de inteligência. A comparação precisa olhar separadamente conhecimento factual, matemática, programação, planejamento longo, uso de ferramentas, navegação na web, visão, memória, velocidade, confiabilidade, autocorreção e autonomia. Um modelo menor pode superar o Astra de 2026 em programação e ainda ficar atrás no uso do computador.
Há também diferença entre ter um modelo com competência semelhante e reproduzir modelo + contexto + tempo de raciocínio + ferramentas + verificação durante horas. O segundo objetivo custa muito mais. A apresentação oficial de GPT-6 Astra e a descrição de Fable 5.1 e Mythos 5.1 ajudam a dimensionar essa diferença.
A capacidade ficou mais barata
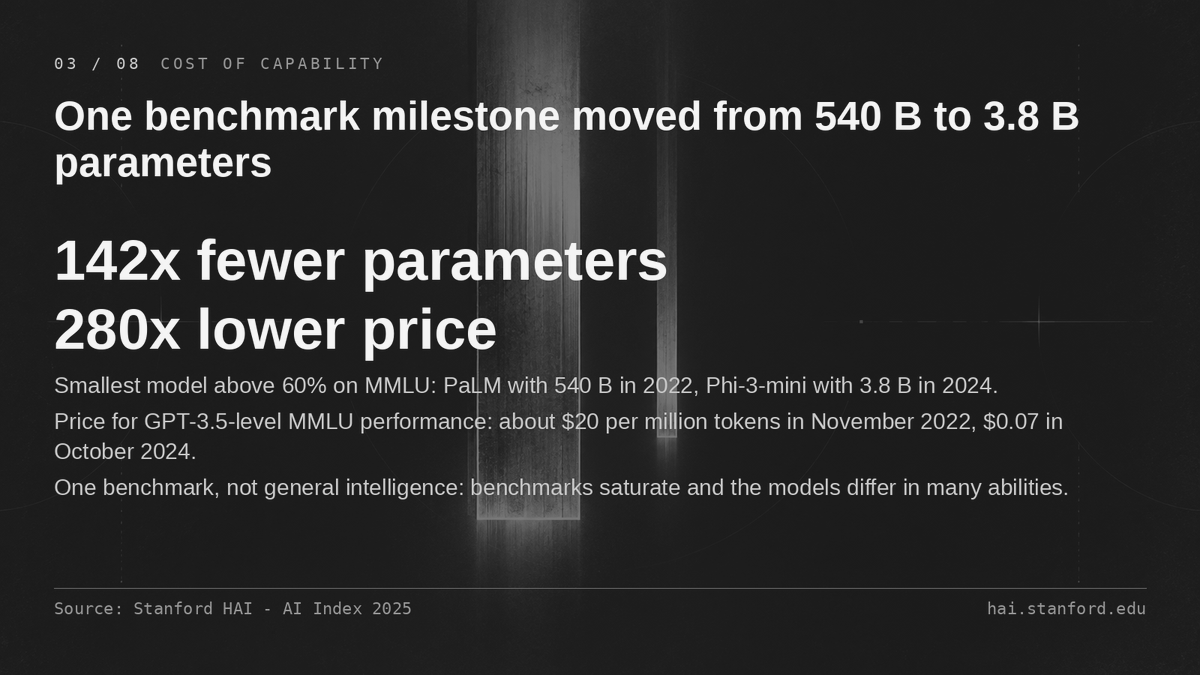
O AI Index de Stanford traz duas comparações úteis. Em 2022, o menor modelo acima de 60% no MMLU tinha 540 bilhões de parâmetros, o PaLM. Em 2024, o Phi-3-mini alcançou o mesmo marco com 3,8 bilhões: aproximadamente 142 vezes menos parâmetros. No mesmo período, o preço de consultas com desempenho próximo ao GPT-3.5 no MMLU caiu de cerca de US$ 20 para US$ 0,07 por milhão de tokens, uma redução superior a 280 vezes.
| Indicador | Ponto inicial | Ponto posterior | Leitura correta |
|---|---|---|---|
| Menor modelo acima de 60% no MMLU | PaLM, 540 bi (2022) | Phi-3-mini, 3,8 bi (2024) | ~142× menos parâmetros para esse marco |
| Preço por milhão de tokens em desempenho similar ao GPT-3.5 no MMLU | ~US$ 20 (nov/2022) | ~US$ 0,07 (out/2024) | Mais de 280× menor nesse recorte |
Isso não torna Phi-3-mini equivalente ao PaLM. MMLU mede apenas uma parte do desempenho, pode saturar, e os modelos diferem em muitas habilidades. A conclusão mais estreita é que um marco específico pode migrar rapidamente de centenas de bilhões para poucos bilhões de parâmetros.
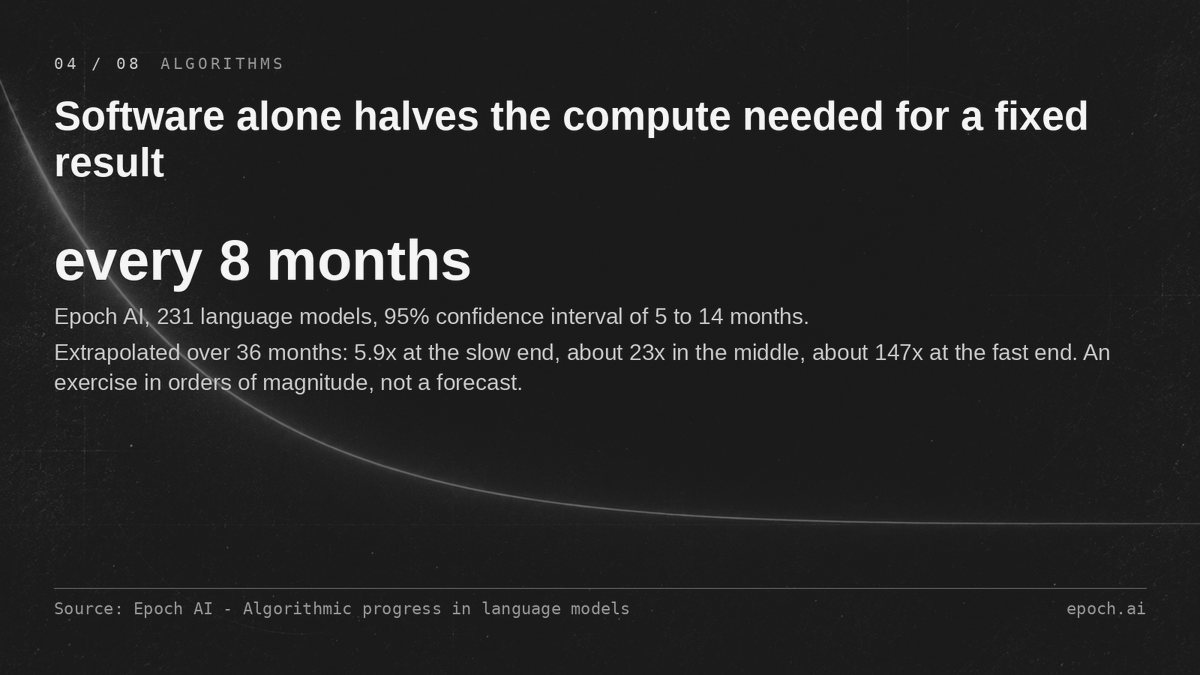
O software também melhora. Em uma análise de 231 modelos, a Epoch AI estimou que o cálculo necessário no pré-treinamento para atingir um desempenho fixo caiu pela metade a cada oito meses, com intervalo de confiança de cinco a catorze meses. Estender esse ritmo por 36 meses daria cerca de 23 vezes menos cálculo; os extremos do intervalo produziriam aproximadamente 5,9 e 147 vezes. É um exercício de escala, não uma previsão. Separar inovação algorítmica de ganhos vindos de mais dados e computação é difícil, e o estudo não cobre toda a etapa posterior ao treinamento.
Caber na memória ainda não significa rodar bem
Hoje já há exemplos da faixa de memória disponível: gpt-oss-20b e gpt-oss-120b foram apresentados para, respectivamente, cerca de 16 GB de memória e uma GPU de 80 GB; o DGX Spark oferece 128 GB de memória unificada; e o Mac Studio com M3 Ultra pode chegar a 512 GB. Isso demonstra capacidade de armazenamento, não velocidade adequada nem preço acessível.
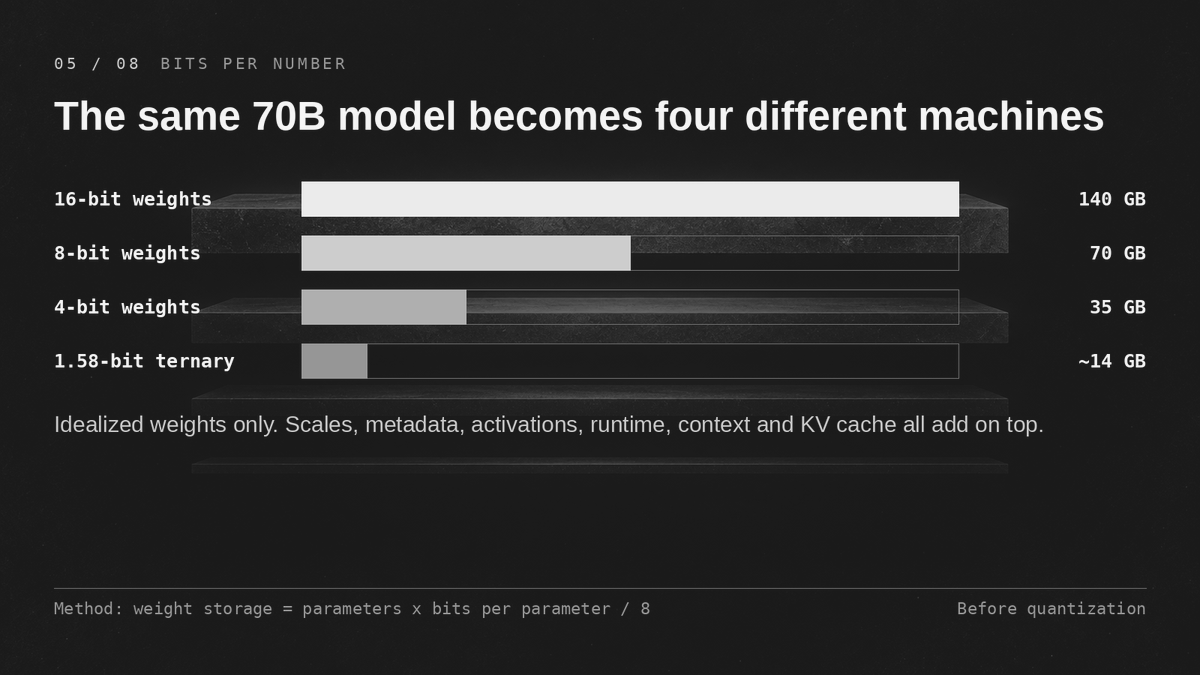
Uma aproximação para o espaço ocupado apenas pelos pesos é: parâmetros × bits por parâmetro ÷ 8.
| Modelo | 16 bits | 8 bits | 4 bits | 2 bits | 1,58 bit |
|---|---|---|---|---|---|
| 70 bilhões | 140 GB | 70 GB | 35 GB | 17,5 GB | ~14 GB |
| 120 bilhões | 240 GB | 120 GB | 60 GB | 30 GB | ~24 GB |
| 600 bilhões | 1,2 TB | 600 GB | 300 GB | 150 GB | ~118 GB |
Esses são pesos idealizados. Escalas de quantização, metadados, buffers, ativações, sistema operacional, contexto e cache KV ocupam espaço adicional. Quando uma sessão usa lotes pequenos, a geração costuma depender mais da largura de banda da memória do que do número de operações anunciado na caixa.
Por que gerar texto demora?
Na geração tradicional, cada token depende do anterior. A leitura da entrada (prefill) admite bastante paralelismo; a escrita (decode) mantém uma cadeia sequencial. O cache KV evita recalcular todo o histórico, mas cresce com o contexto e com o número de sessões. Por isso, um sistema doméstico precisa equilibrar pesos, cache e ativações, e cálculo gasto no raciocínio. Técnicas como geração especulativa e previsão de múltiplos tokens reduzem a espera, sem apagar todas essas restrições.
Nem toda decisão precisa virar uma frase
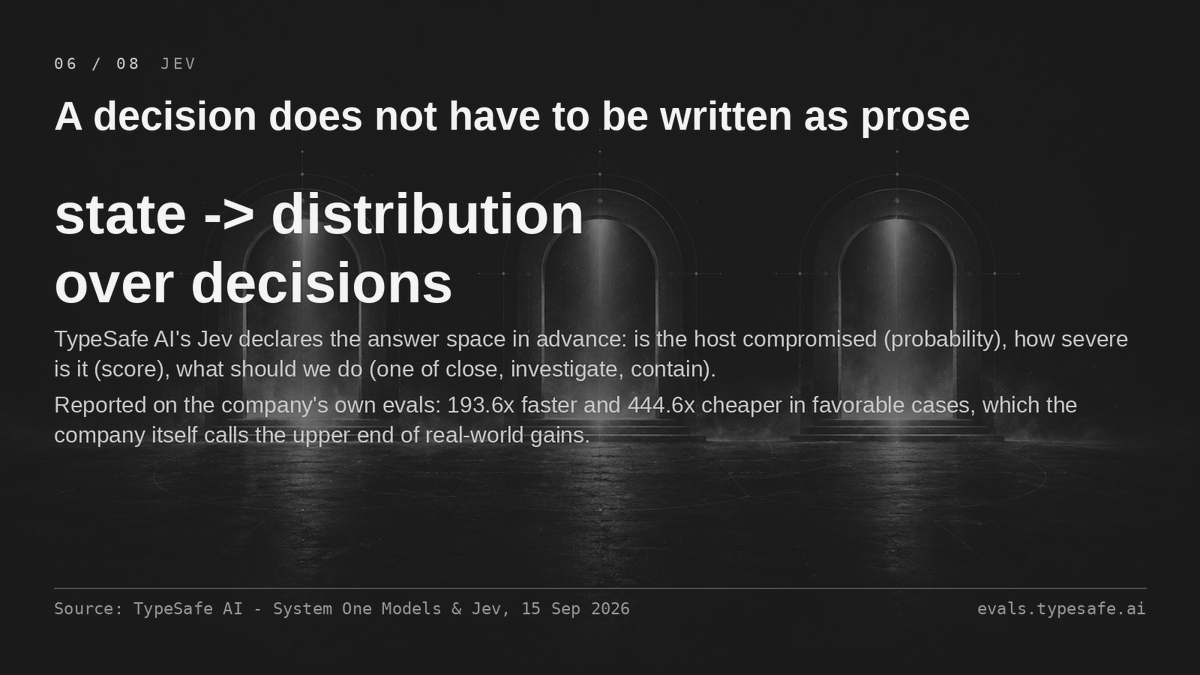
O Jev, da TypeSafe AI, propõe outra interface: converter um estado de entrada em probabilidades, pontuações e escolhas estruturadas. Num incidente de segurança, por exemplo, o sistema pode responder à probabilidade de comprometimento, à gravidade e à ação entre “encerrar”, “investigar” ou “conter”, em vez de redigir uma análise livre para cada etapa.
Nos testes publicados pela empresa, aparecem casos 193,6 vezes mais rápidos e 444,6 vezes mais baratos frente a uma referência formada pelo consenso de Astra e Fable em tarefas delimitadas. A própria empresa diz que são ganhos no extremo superior, medidos em fluxos definidos por sua equipe. Isso sugere potencial para decisões estruturadas, mas não demonstra que Jev tenha inteligência geral equivalente por 444 vezes menos custo.
Saídas fechadas podem impedir respostas fora do formato permitido. Ainda assim, uma escolha pode estar errada, basear-se em um fato inventado ou expressar confiança mal calibrada. São problemas diferentes.
Como comprimir o trabalho sem perder utilidade
Especialistas esparsos. Em modelos MoE, um roteador escolhe poucos especialistas por token. O DeepSeek-V3 foi descrito com 671 bilhões de parâmetros no total e 37 bilhões ativados por token. Todos os especialistas ainda precisam estar disponíveis em algum nível da memória, e movê-los pode prejudicar a latência.
Quantização. Comprimir um modelo já treinado é conveniente, mas preservar a qualidade fica mais difícil perto de 2 bits. O BitNet b1.58 2B4T toma outro caminho: treina desde o início com pesos ternários. Seu modelo público tem cerca de 2 bilhões de parâmetros; esse resultado ainda não prova o mesmo comportamento em centenas de bilhões. Um runtime apropriado também importa: o bitnet.cpp relata ganhos de velocidade em seus experimentos. Suporte nativo a operações de baixa precisão em chips comuns poderia reduzir leitura de memória e custo matemático juntos.
Destilação. Um modelo grande pode produzir exemplos e trajetórias para treinar outro menor. O DeepSeek-R1 mostrou como padrões de raciocínio desenvolvidos em modelos grandes podem ajudar modelos menores. Descobrir uma habilidade pode custar caro; repetir uma aproximação dela, pouco. Há limites: modelos pequenos não absorvem capacidade infinita e tendem a perder desempenho em situações fora da distribuição de treino.
Treinamento melhor e cálculo adaptativo. Dados mais limpos, currículos melhores e treinamento posterior elevam o que cada parâmetro aprende. Na resposta, o sistema pode gastar pouco quando a confiança é alta, escalar para raciocínio quando necessário e verificar antes de escalar novamente. Isso economiza, mas também lembra que um modelo pequeno pode caber na RAM e ainda ser lento demais quando precisa pensar por milhares de etapas.
Outras arquiteturas. Mamba explora espaços de estado seletivos, com custo que escala linearmente com o comprimento da sequência; LLaDA explora geração por difusão e mascaramento. Esses resultados não garantem a substituição dos Transformers, mas mostram que suas escolhas atuais não são as únicas possíveis.
O computador de 2029 provavelmente rodará um sistema
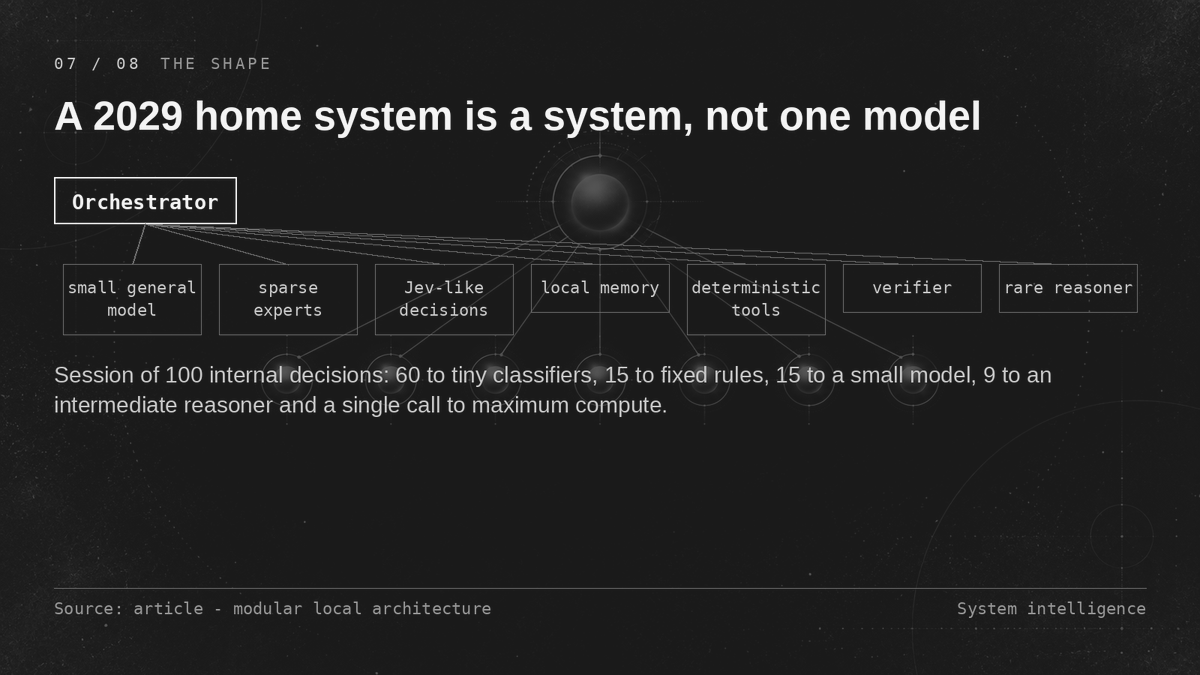
O arranjo local mais plausível não depende de um único modelo enorme. Um orquestrador pode escolher entre um modelo geral pequeno, especialistas de código, visão e áudio, classificadores de decisões, busca em memória local, ferramentas determinísticas, um verificador e um raciocinador caro usado apenas quando necessário.
Imagine 100 decisões internas numa sessão. Um desenho possível é enviar 60 a classificadores pequenos, 15 a regras fixas, 15 a um modelo geral menor, nove a um raciocinador intermediário e só uma ao processamento máximo. É um exemplo ilustrativo, mas revela a economia: a experiência final pode ser próxima da de um agente poderoso sem pagar o custo máximo em todas as etapas.
Além do custo, executar IA localmente oferece privacidade, funcionamento offline, preço marginal previsível e menor latência de rede. Ganhos de eficiência, porém, também podem aumentar o uso total: quando decisões ficam baratas, passam a ser aplicadas a mais arquivos, eventos, sensores e etapas de trabalho.
Três cenários para setembro de 2029
| Cenário | Probabilidade subjetiva | O que eu esperaria |
|---|---|---|
| Conservador | 25% a 30% | PCs comuns rodam excelentes modelos de 20B a 40B; competência geral de 2026 ainda exige estação cara ou nuvem. |
| Continuidade acelerada | 50% a 55% | 32 a 64 GB bastam para modelos muito capazes; 64 a 128 GB sustentam sistemas próximos da fronteira de 2026. |
| Salto de eficiência | 15% a 20% | Treinamento em precisão ultrabaixa, novas arquiteturas e hardware dedicado levam utilidade de 2026 a máquinas comuns. |
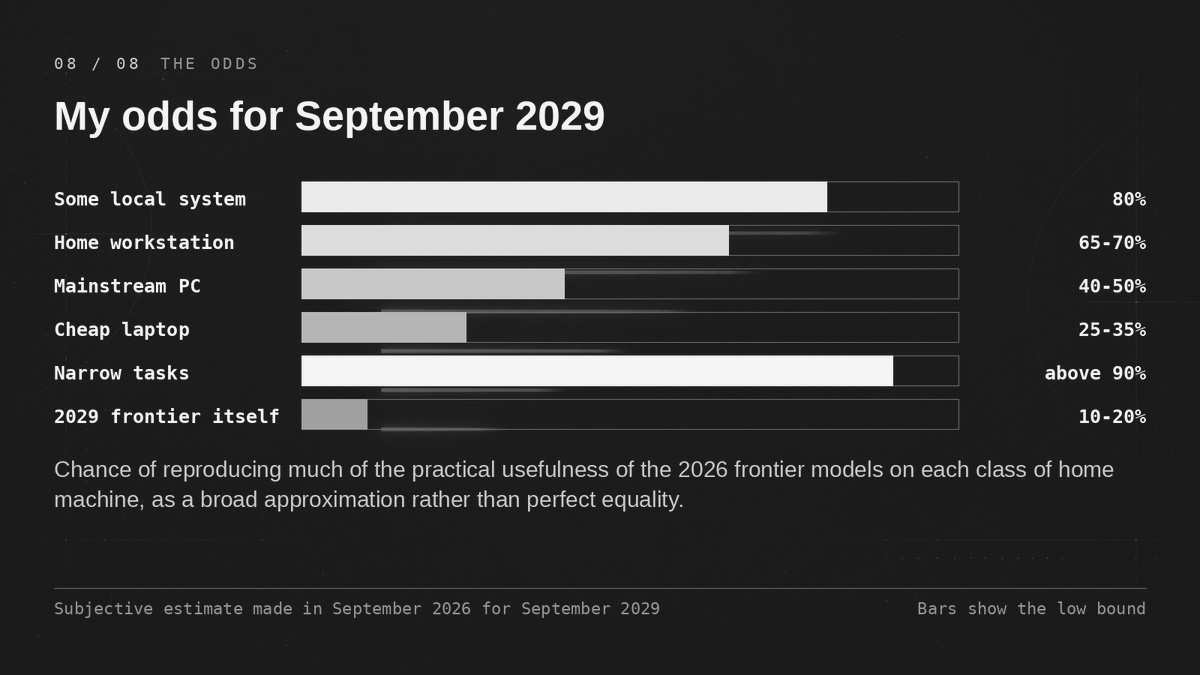
Minha estimativa agregada depende do equipamento e da definição de equivalência:
| Alvo em setembro de 2029 | Chance estimada |
|---|---|
| Algum sistema local reproduz grande parte da utilidade prática da fronteira de 2026 | ~80% |
| Estação doméstica potente | 65% a 70% |
| PC comum com 32 a 64 GB | 40% a 50% |
| Notebook ou mini-PC barato com 16 a 32 GB | 25% a 35% |
| Habilidades específicas em modelos pequenos ou especializados | Acima de 90% |
| A própria fronteira de 2029 roda localmente e a baixo custo | 10% a 20% |
São probabilidades pessoais, não frequências medidas. Consideram uma aproximação ampla da capacidade prática, possivelmente por um sistema modular. Exigir igualdade perfeita em todos os benchmarks reduziria as estimativas.
O que pode impedir esse resultado?
Algumas habilidades gerais podem exigir escala irredutível. Destilação talvez preserve habilidades conhecidas sem preservar flexibilidade diante do novo. Contextos longos, multimodalidade e vários agentes podem fazer o cache e o estado de execução crescer mais depressa do que a memória doméstica. A capacidade de fronteira pode continuar dependendo de busca maciça, simulações e centenas de processos paralelos. Modelos abertos podem permanecer atrás dos fechados; largura de banda barata pode avançar devagar; quantização extrema pode perder qualidade. E benchmarks saturados podem sugerir uma transferência de capacidade maior do que a real.
O próprio mercado tende a gastar ganhos de eficiência em mais capacidade: se a inferência ficar dez vezes mais barata, um laboratório pode cobrar menos ou deixar o sistema pensar dez vezes mais, ampliar o contexto e executar mais agentes. Por isso, é plausível aproximar em casa a utilidade de 2026 sem conseguir hospedar a fronteira de 2029.
O que acompanhar daqui para frente
Os indicadores mais úteis são: menor modelo que alcança a fronteira de 2026 em avaliações novas; parâmetros ativos por token; memória mínima com contexto realista; tokens por segundo em hardware de consumo e lote um; energia por tarefa; tokens de raciocínio por problema resolvido; qualidade em 3, 2 e 1,58 bit; largura de banda da memória unificada; agentes locais em tarefas de horas; qualidade do roteamento entre especialistas; compressão do cache KV; distância entre modelos abertos e fechados; e validação independente de arquiteturas como Jev.
Se, até o fim de 2027, modelos de 30B a 70B reproduzirem com consistência as capacidades de 2026 em programação autônoma, uso do computador e raciocínio, e desktops de 64 a 128 GB de memória rápida se tornarem comuns, eu aumentaria a estimativa. Se continuarmos precisando de centenas de bilhões de parâmetros ativos e enormes orçamentos de raciocínio, eu a reduziria.
As ilustrações conservam texto em inglês; as descrições estão em português. As probabilidades sobre 2029 são estimativas pessoais, sujeitas a revisão.
 Inteligência artificial
 Inteligência artificial