Inteligência artificial · caderno de investigação
Por que sites bloqueiam robôs e IAs, e onde estão os limites?
Como sites reconhecem visitas automatizadas, por que bloqueiam e onde entram termos de uso e leis. Uma resposta técnica não resolve, sozinha, a questão da permissão.
Neste artigo
Você abre uma página e precisa provar que não é um robô. Em outro momento, uma consulta funciona no computador de casa, mas falha quando é enviada de um servidor na nuvem. A página pode ser a mesma; o caminho até ela, não.
Os bloqueios envolvem segurança, custos e regras de acesso. Uma resposta técnica não resolve, sozinha, a questão da permissão.
O que faz um robô na web?
Um robô da web é um programa que acessa páginas ou serviços automaticamente. Um rastreador é um tipo de robô que percorre endereços e coleta informações. Ele pode ajudar a localizar páginas para uma busca, verificar se um serviço funciona ou reunir material para outros usos.
Alguns robôs cumprem tarefas esperadas; outros podem sobrecarregar serviços ou acessar conteúdo sem autorização.
Segundo a empresa de segurança Imperva, mais de 53% do tráfego web observado por ela em 2025 era automatizado. É uma medição de fornecedor, não um censo de toda a internet. Ela inclui robôs de vários tipos e não corresponde à parcela de tráfego de IA.
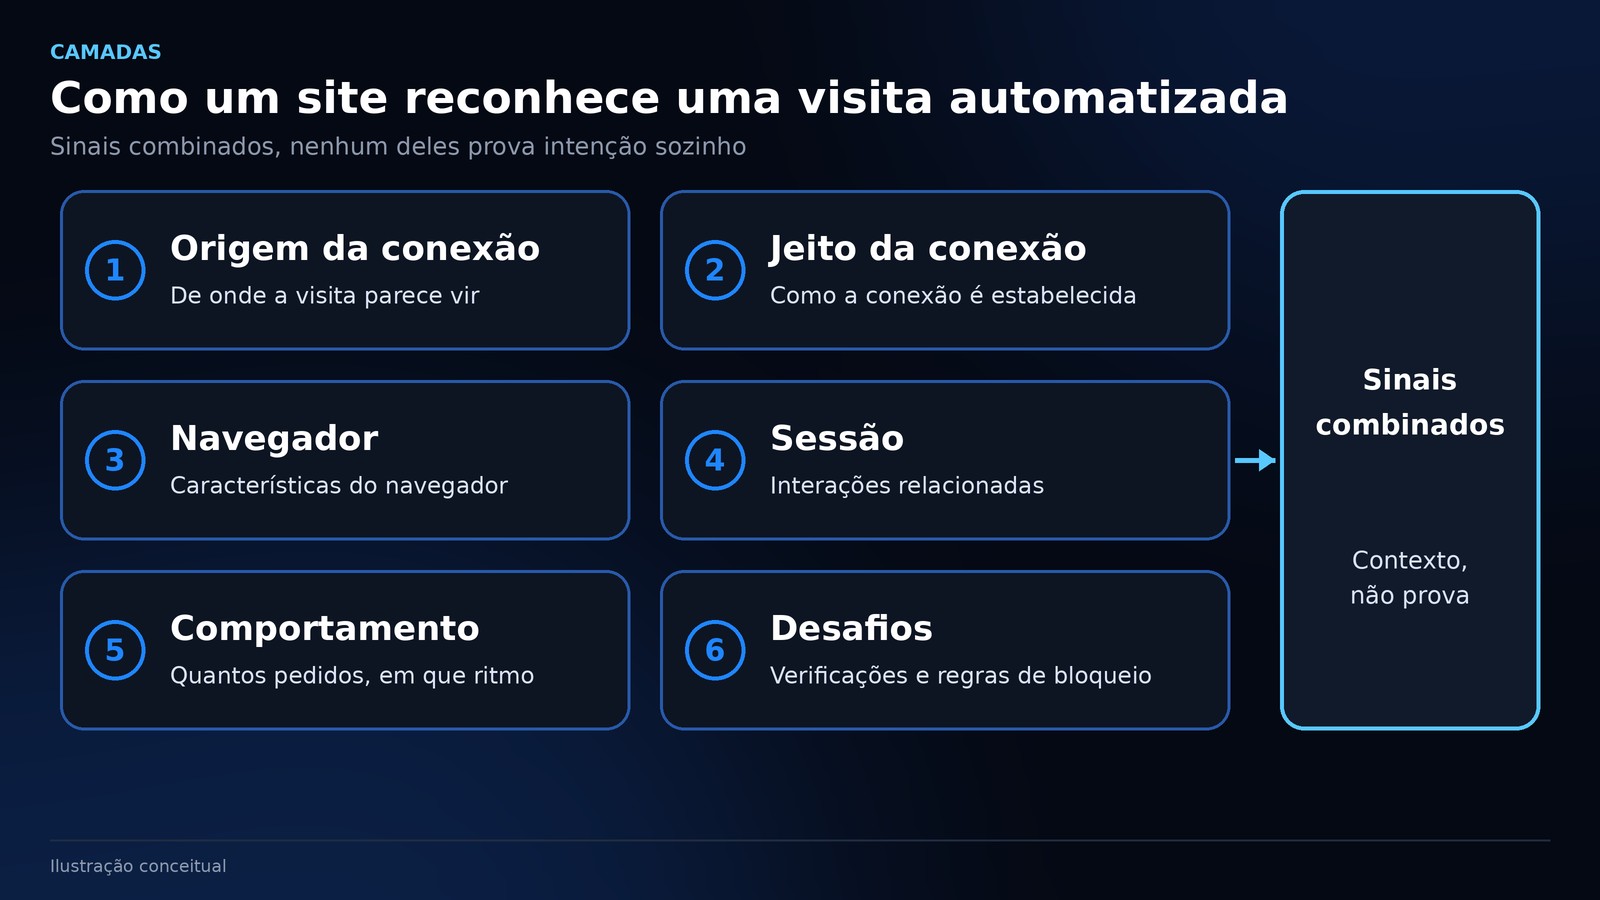
Como um site pode reconhecer uma visita automatizada?
Uma VPS é um servidor virtual privado alugado em um provedor. Uma consulta enviada dali pode ter sinais diferentes da mesma consulta no computador pessoal.
Uma primeira camada olha para a origem da conexão. O endereço IP identifica uma origem de rede na comunicação; algumas bases também classificam endereços associados a hospedagem ou VPN. Uma VPN é um serviço que encaminha a conexão por outra rede. Essas classificações dão contexto, mas não identificam uma pessoa nem provam intenção maliciosa.
Outra camada observa como a conexão é estabelecida e como as solicitações são feitas. Uma impressão digital da conexão, ou fingerprint, é um conjunto de características que ajuda a distinguir padrões de comunicação. A Cloudflare descreve sinais desse tipo e informações agregadas de solicitações; isso não revela a regra usada por cada site.
Uma sessão é um conjunto de interações relacionadas reconhecidas pelo serviço. A proteção pode analisar sinais da sessão e do navegador.
Há ainda o comportamento: quantas solicitações chegam, em que sequência e em quanto tempo. Um limite de uso, ou cota, restringe a quantidade ou a frequência de pedidos. Ele pode proteger a capacidade do serviço mesmo quando a atividade não tem intenção de causar dano.
Por fim, o site pode apresentar um desafio ou aplicar uma regra de bloqueio. CAPTCHA é um desafio criado para ajudar a distinguir interação humana de automação. Um firewall de aplicação, por sua vez, é uma proteção que aplica regras ao tráfego de um site.
Sinais podem ser combinados. Nenhum deles sozinho prova que uma pessoa é um robô ou revela a causa de um bloqueio.
Quando a proteção também atrapalha pessoas
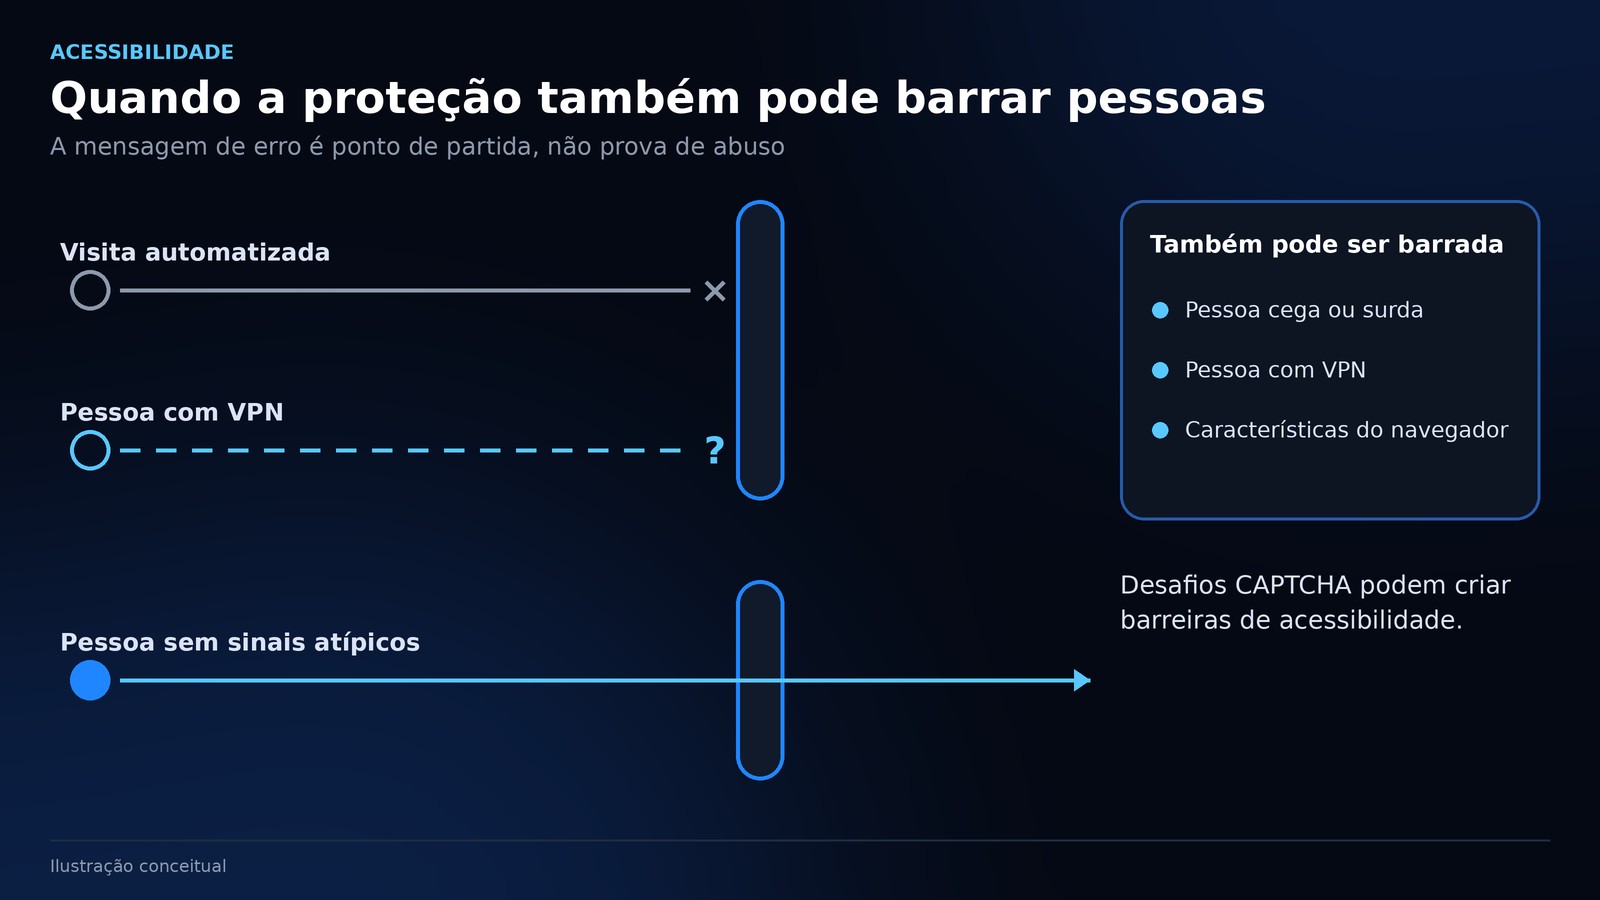
Segundo a W3C WAI, desafios CAPTCHA podem criar barreiras para pessoas cegas, surdas ou com determinadas deficiências cognitivas.
Uma VPN ou características do navegador podem ser sinais usados na avaliação e, em alguns casos, afetar a classificação de uma visita. Não localizamos uma taxa confiável de falsos bloqueios nesses casos. Por isso, a mensagem de erro deve ser tratada como um ponto de partida para investigar, não como prova de abuso.
Por que bloquear?
Bloqueios podem proteger recursos e reduzir o custo de processar solicitações automatizadas indesejadas.
Publicações também podem querer controlar a coleta e o uso de suas páginas no treinamento de IA.
Segundo dados da Cloudflare, na rede analisada pela empresa, a média de janeiro a julho de 2025 foi de 1.437,8 páginas rastreadas por visita de referência para a OpenAI. Na comparação apresentada para o Google, a média foi de 11,8. Trata-se de uma razão agregada entre páginas rastreadas e visitas de referência, não do percentual de pessoas nem de uma medida universal da web.
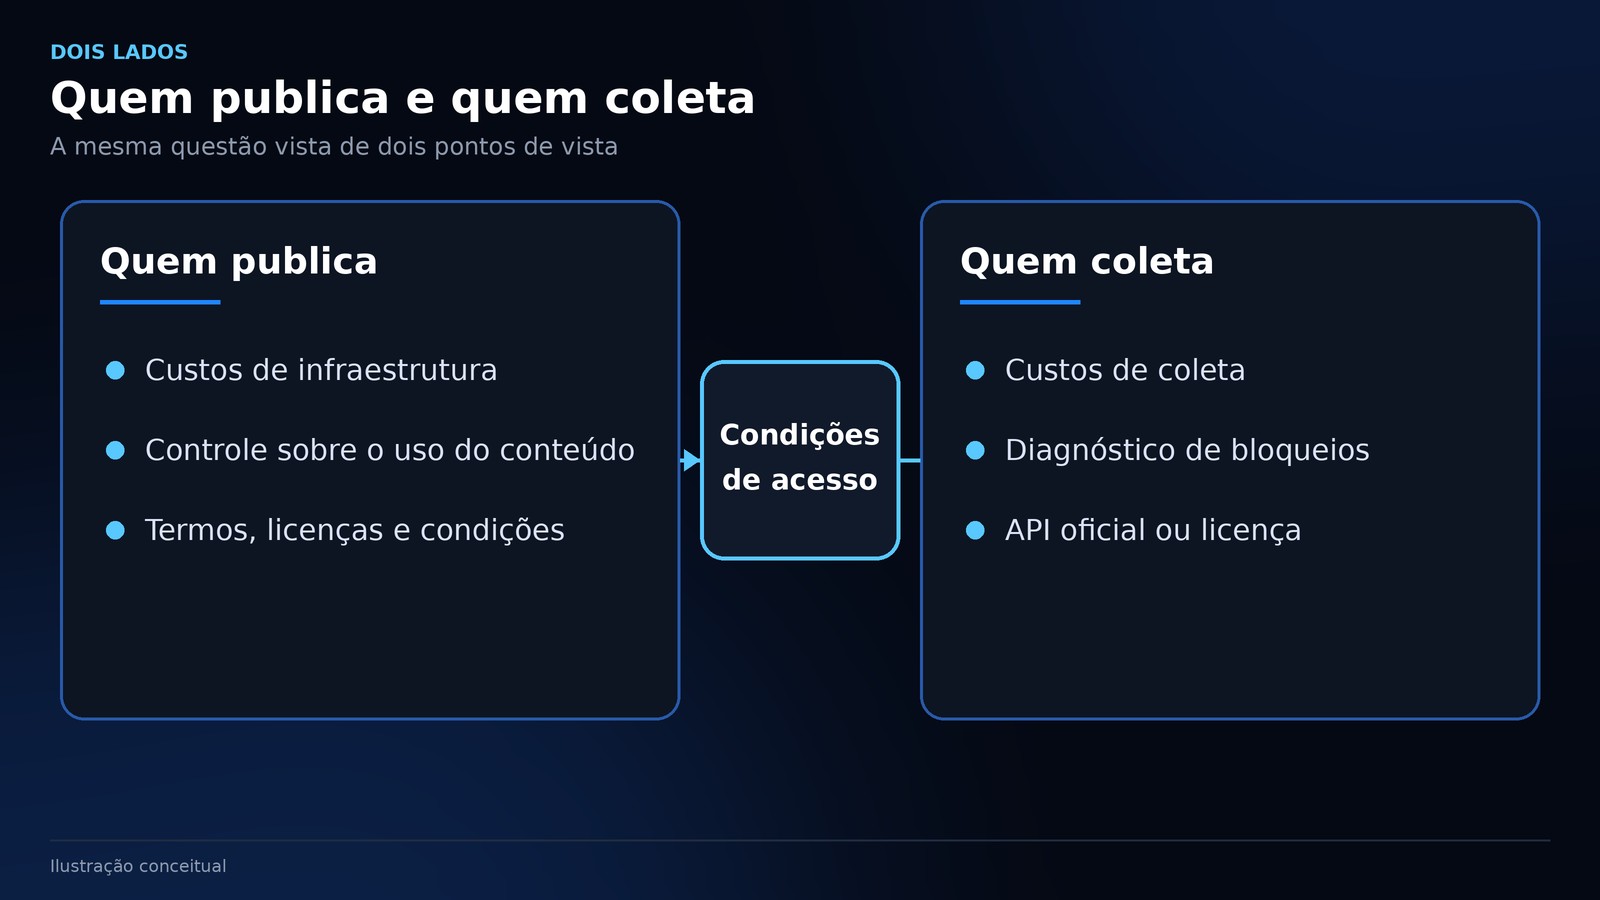
Dois lados da mesma questão
Do ponto de vista de quem publica conteúdo
Quem publica pode se preocupar com custos e controle sobre o uso de conteúdo para treinar IA. A razão apresentada pela Cloudflare ilustra a discussão, dentro dos limites da medição.
Termos de uso, licenças e cobrança por rastreamento são maneiras de estabelecer condições para o acesso e o uso. Cada alternativa depende das regras e dos acordos aplicáveis.
Do ponto de vista de quem coleta ou usa dados
Nas discussões públicas que examinamos, pessoas que coletam dados mencionam custos e dificuldade para diagnosticar bloqueios. Algumas também procuram uma API oficial; acordos de licença são outro caminho possível. São relatos de uma amostra pequena, não uma descrição de todas as pessoas que coletam dados.
E dá para contornar?
Existem categorias de soluções que tentam mudar a forma como uma solicitação chega ao destino. Algumas alteram a origem da conexão; outras procuram reproduzir características de um navegador. Há também navegadores alterados e serviços gerenciados que reúnem diferentes recursos para acesso automatizado.
Cada categoria atua sobre parte dos sinais, sem garantir acesso. Uma resposta recebida não demonstra autorização nem direito de reutilizar conteúdo. Proteções e tentativas de contorno mudam continuamente.
Este artigo descreve categorias em termos gerais. Não traz instruções passo a passo, configurações, código nem indicações de qual técnica funciona contra um serviço específico.
Pode? O que dizem os termos e a lei
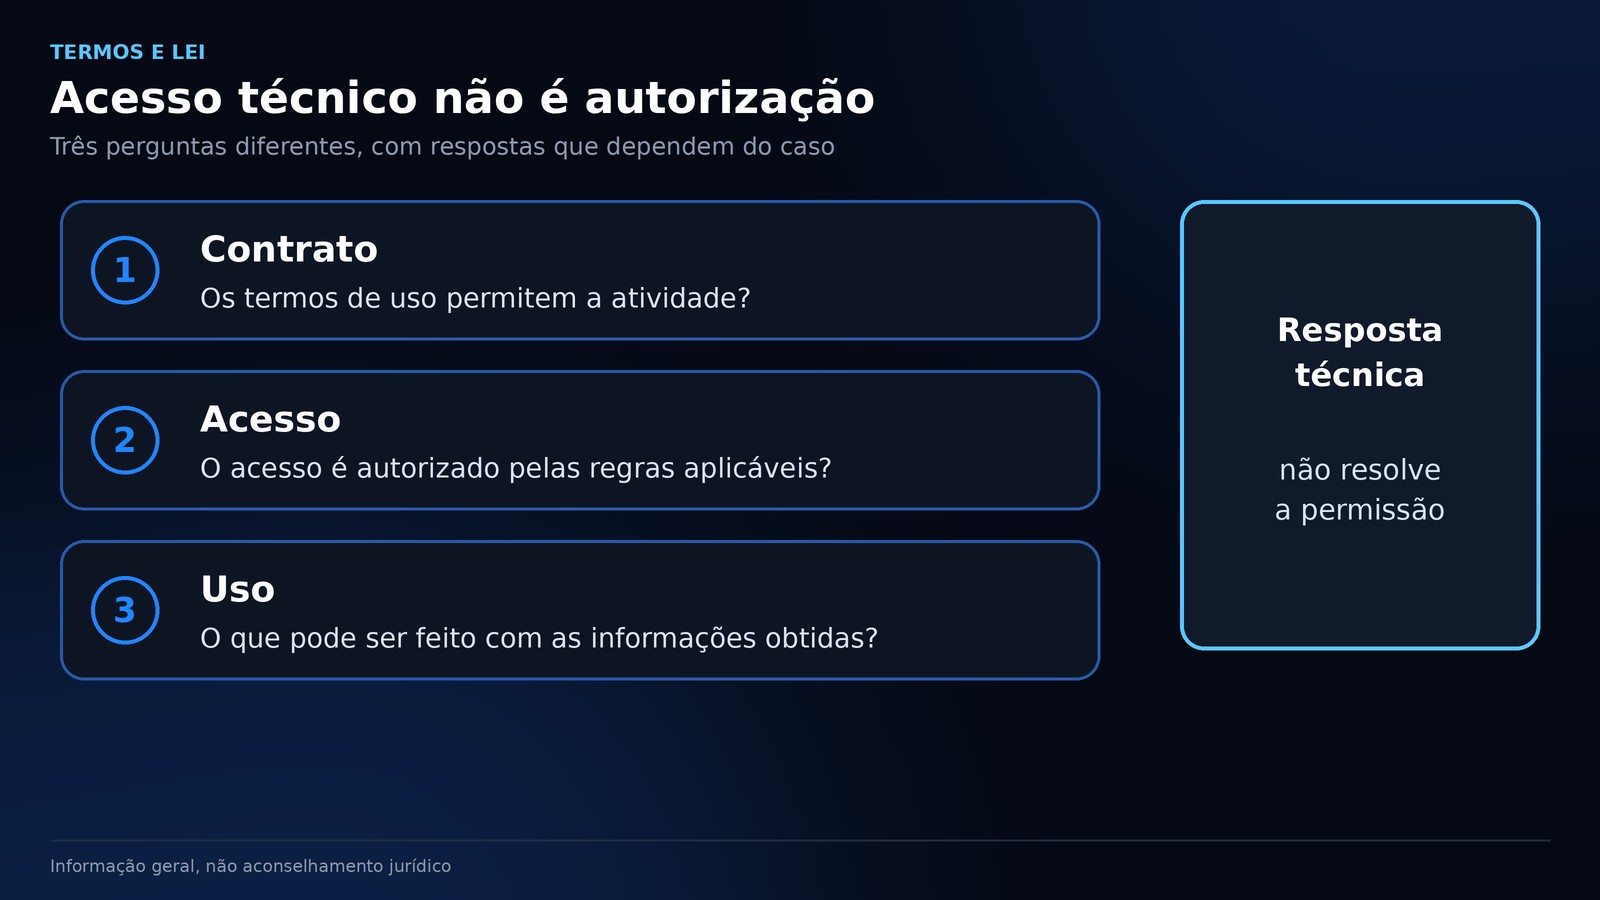
Há três perguntas diferentes. Primeiro: o contrato ou os termos de uso permitem a atividade? Segundo: o acesso é autorizado segundo as regras jurídicas aplicáveis? Terceiro: o que pode ser feito com as informações obtidas? A resposta depende dos fatos, da jurisdição e dos direitos envolvidos.
Descumprir termos pode gerar consequências contratuais, dependendo de sua validade e aplicação. Isso não transforma automaticamente toda violação em crime. Da mesma forma, uma página aparecer publicamente não resolve, por si, todas as questões sobre coleta e reutilização.
O arquivo chamado robots.txt informa regras para rastreadores que as seguem. A RFC 9309, que descreve esse padrão, esclarece que ele não é um mecanismo de autorização. O arquivo não é uma lei por si; ignorá-lo pode fazer parte de uma análise mais ampla, mas a norma técnica não decide sozinha o contrato ou a lei aplicável.
O que alguns serviços dizem
Os textos abaixo foram consultados em 16/11/2026 e podem mudar. Os termos do Reddit permitem rastreamento sob condições ligadas ao robots.txt e restringem a extração de dados sem consentimento prévio por escrito. Já os termos do Google (versão dos Estados Unidos, vigente desde 30/07/2026) proíbem acesso automatizado que viole instruções legíveis por máquina. Em ambos os casos, outras condições aplicáveis ao serviço devem ser examinadas.
O contrato de serviços da OpenAI restringe extração fora do permitido e o contorno de limites e proteções (versão atualizada em 01/12/2025). Esse documento é um acordo de serviços; não devemos presumir que a mesma cláusula descreva automaticamente todos os termos de consumidor.
As condições do Amazon Freight excluem da licença mineração de dados, robôs e ferramentas semelhantes (texto atualizado em 2020). Esse exemplo se refere ao serviço Freight, não a todos os sites da Amazon. Não verificamos os termos do comércio da empresa.
Já a política de uso aceitável do GitHub distingue coleta por páginas e uso da API, uma interface oficial para programas conversarem com o serviço. Ela também restringe usos de dados para spam e venda de dados pessoais. As regras específicas dependem do que se pretende acessar e fazer com o resultado.
Brasil: acesso, dados e obras
O artigo 154-A do Código Penal trata de invasão de dispositivo informático, em redação dada pela Lei 14.155/2021, e contém elementos que precisam ser analisados no caso concreto. Não se deve presumir que toda coleta automatizada ou desrespeito a robots.txt preencha esse tipo penal.
A Lei Geral de Proteção de Dados, ou LGPD, pode incidir quando há tratamento de dados pessoais. Tratar dados significa realizar operações como coletar, usar ou armazenar informações. As condições e exceções da lei precisam ser avaliadas conforme a finalidade e o contexto.
Em tramitação, o projeto de lei 2338/2023, sobre inteligência artificial, ainda não é lei: em 16/11/2026, a Câmara o registrava aguardando parecer em comissão especial, e o Senado informava o envio após a aprovação de um substitutivo. O andamento muda com frequência.
O Marco Civil da Internet estabelece princípios e direitos relacionados à internet e à privacidade. A Lei de Direitos Autorais também pode importar quando há uso de obras protegidas. A aplicação à coleta ou ao treinamento de IA depende do conteúdo, da finalidade e dos fatos; não há resposta única para todos os casos.
O caso da Meta mostra por que olhar para as condições importa. Em julho de 2024, a Autoridade Nacional de Proteção de Dados suspendeu cautelarmente determinado tratamento de dados para treinamento. Em agosto, a ANPD suspendeu essa medida, após aprovar um plano com restrições e mecanismos de oposição. Não verificamos atualizações posteriores a 2024; o episódio não equivale a uma proibição geral de todo treinamento.
Estados Unidos: decisões com alcance próprio
Em Van Buren v. United States, de 2021, a Suprema Corte discutiu o alcance de exceder acesso autorizado na lei federal sobre fraudes e abuso informático. A decisão tratou dos fatos e da expressão examinada naquele processo. Não declarou permitida toda coleta automatizada.
Em hiQ v. LinkedIn, o tribunal analisou, em 2022, uma medida preliminar envolvendo páginas públicas. Mais tarde, o litígio teve julgamento por consentimento, em dezembro de 2022. O acordo fixou o pagamento de US$ 500 mil pela hiQ e uma ordem permanente que a proíbe de acessar a plataforma em violação dos termos de uso, inclusive por meios automatizados. Os fundamentos relativos à lei de acesso e ao contrato não são a mesma pergunta; não verificamos movimentos posteriores aos documentos consultados, até 16/11/2026.
Em Meta v. Bright Data, em 23/01/2024 o tribunal federal decidiu que os termos da Meta não se aplicavam à coleta feita sem login, de dados visíveis ao público, e deu razão à Bright Data nas alegações de quebra de contrato examinadas. A conclusão se limita a esse tipo de coleta e aos fatos daquele processo. O andamento posterior e eventuais recursos não foram verificados até 16/11/2026.
União Europeia: conteúdo e dados pessoais
A Diretiva 2019/790 prevê uma exceção para mineração de texto e dados de obras acessíveis legalmente, sujeita à reserva adequada de direitos. Se um arquivo robots.txt vale como essa reserva em cada situação é uma questão que depende do caso. A diretiva também trata separadamente de pesquisa científica sob condições próprias. Mineração, nesse contexto, é a análise automatizada de textos e dados para encontrar informações ou padrões.
O GDPR é o regulamento europeu de proteção de dados pessoais e pode impor condições ao tratamento desses dados. O AI Act, regulamento europeu sobre IA, prevê obrigações de conformidade autoral para provedores de modelos de uso geral, em vigor desde 02/08/2025, com regras de transição para modelos anteriores, segundo a Comissão Europeia. Sobre dados pessoais em modelos de IA, o Comitê Europeu de Proteção de Dados publicou o parecer 28/2024, que examina caso a caso questões como anonimização e interesse legítimo. A aplicação concreta e as regras nacionais dependem do caso.
Caminhos para um acesso combinado
Uma API é uma forma documentada de programas solicitarem dados ou funções a um serviço. Quando existe uma API oficial adequada, ela pode esclarecer quais dados estão disponíveis e quais limites se aplicam. Isso não dispensa verificar custos, termos e direitos sobre o conteúdo.
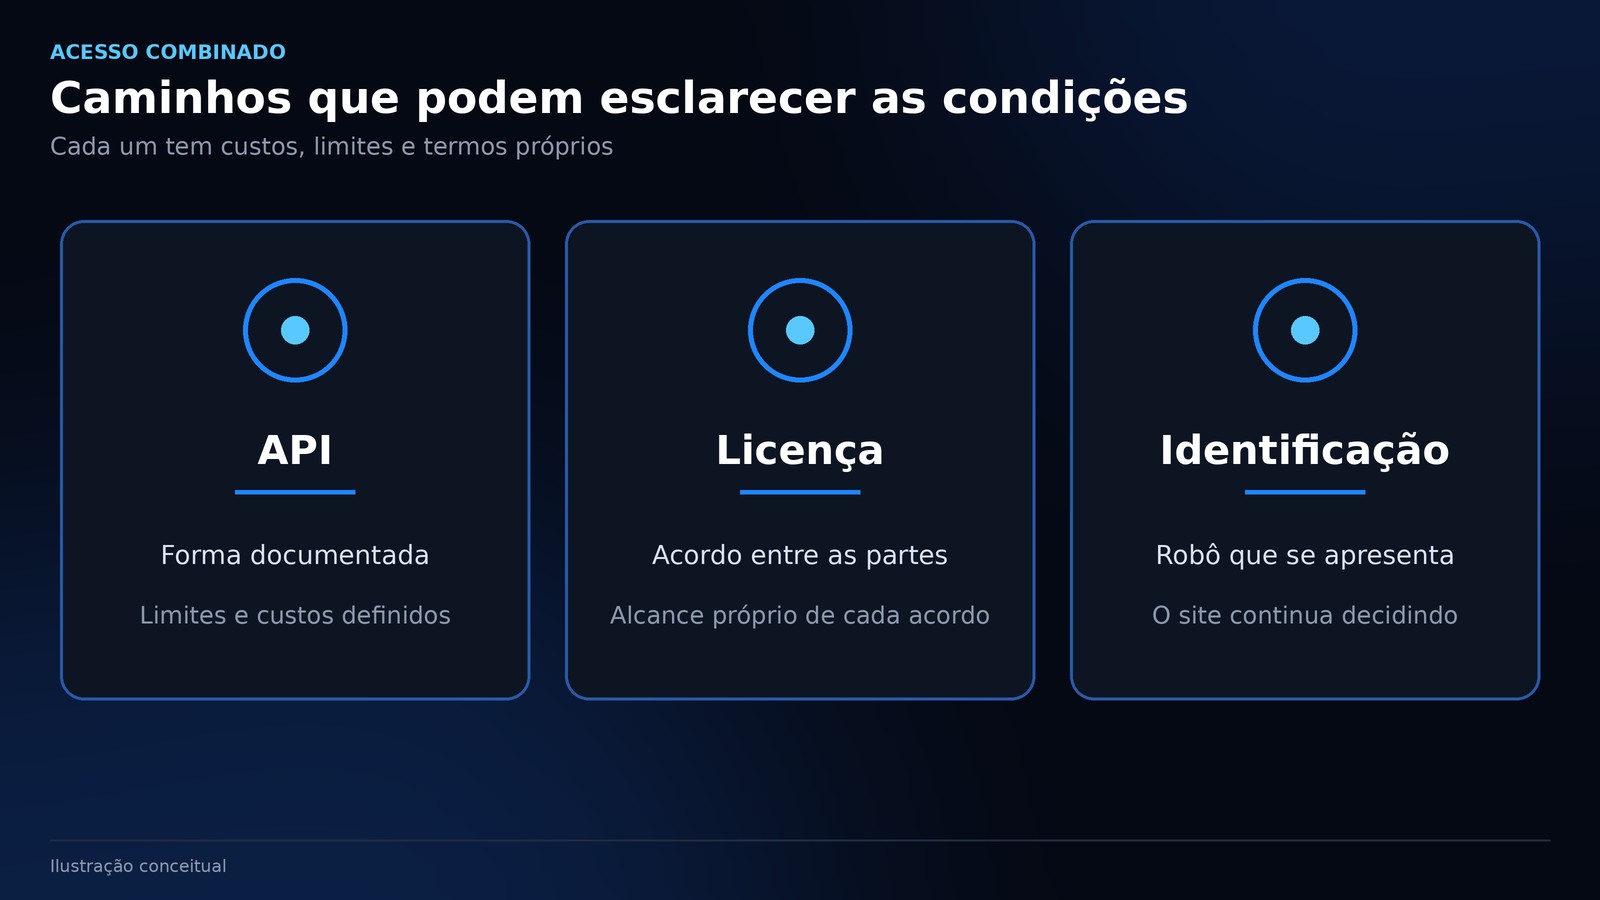
Licenças e parcerias são outro caminho. A OpenAI anunciou acordos de conteúdo com o Guardian, em fevereiro de 2025, e com o Financial Times, em abril de 2024. Não verificamos se esses acordos continuam vigentes. Cada acordo tem seu próprio alcance; uma licença negociada entre duas partes não autoriza automaticamente outras pessoas a usar o mesmo material.
Um robô também pode se identificar e passar por verificação. O Web Bot Auth usa assinaturas digitais para ajudar a verificar a identidade de robôs. Uma assinatura digital é uma forma de verificar a origem de uma mensagem. Identificar um robô não dá a ele direito de acesso: o site continua decidindo sua política.
A Cloudflare também descreveu mecanismos de cobrança por rastreamento. A ideia é permitir condições comerciais para determinados acessos, conforme a implementação. Não verificamos a disponibilidade nem o estágio atual desse recurso, e o anúncio não significa que todos os sites o adotem.
O que aparece nas conversas da comunidade
Em dez discussões públicas examinadas, pessoas que coletam dados comentam custos, diagnóstico e acesso oficial. Os relatos não são verificados nem representam toda a comunidade.
Do outro lado, participantes que administram sites ou discutem o tráfego recebido relatam preocupação com consumo de recursos e desempenho. Duas discussões também mencionam o risco de barrar usuários legítimos ao restringir o tráfego. Parte dos relatos trata de robôs em geral, sem comprovar que sejam rastreadores usados para treinar IA.
A skill que criei: o que faz, pontos positivos e limites
Criei a skill grilling-para-contornar-bloqueios-antibot-em-vps para ajudar quem usa agentes de IA a lidar com esses problemas com sabedoria e responsabilidade. Uma skill é um conjunto de instruções reutilizáveis que orienta o trabalho de agentes de IA.
O nome fala em contornar bloqueios; “grilling” se refere a uma técnica de perguntas em árvore.
Pontos positivos:
Conduz uma entrevista em árvore de decisões e separa fatos de hipóteses.
Organiza possíveis causas por camadas: origem e jeito da conexão, navegador, sessão e política do site.
Propõe testar uma família de variáveis por vez, respeitar limites informados pelo serviço e considerar uma API ou acesso identificado.
Prevê um plano com critérios de sucesso e falha e uma forma de desfazer a mudança.
Organiza perguntas e decisões sem ampliar permissões nem prometer acesso.
Limites:
Não decide se o acesso é autorizado nem analisa termos de uso, contratos ou lei. A verificação dessas questões continua com quem usa a skill e, quando necessário, com um profissional.
O nome menciona contornar bloqueios, mas a skill não garante acesso nem aceitação pelo site.
O material técnico que a acompanha é uma pesquisa documental de 15/11/2026; versões e produtos podem mudar.
As alternativas citadas não foram testadas no ambiente de quem usa. Comparações de testes podem envolver fatores que não são controlados.
Resumo dos pontos positivos e negativos
| Tema | Pontos positivos | Pontos negativos ou riscos |
|---|---|---|
| Bloqueios de robôs | Ajudam a proteger serviços e limitar solicitações. | Podem barrar visitantes legítimos e criar barreiras de acessibilidade. |
| Coleta automatizada de dados | Ajuda a localizar páginas e reunir informações. | Pode aumentar custos de infraestrutura e envolver conteúdo ou dados sujeitos a regras. |
| Caminhos autorizados: APIs, licenças, robôs identificados e cobrança por rastreamento | Podem esclarecer condições de acesso ou permitir identificação. | Há limites, custos e disponibilidade variável; identificação não concede acesso. |
| A skill descrita no artigo | Organiza perguntas, hipóteses e planos de teste. | Não decide autorização nem garante acesso; alternativas não foram testadas no ambiente de quem usa. |
Três perguntas para pensar
Que acesso foi autorizado, e para qual finalidade?
Como proteger um serviço sem impedir que pessoas legítimas o utilizem?
Quem deve poder decidir como um conteúdo é coletado e reutilizado?
Fontes e situação das afirmações
“Verificada” identifica o conteúdo da fonte ou a alegação atribuída, conforme a pesquisa; não garante aplicação a outro caso. Os pontos que não foram verificados, ou que dependem do caso concreto, estão indicados na tabela.
| Afirmação | Origem com o link | Situação |
|---|---|---|
| Mais de 53% do tráfego observado em 2025 era automatizado | Imperva | verificada como medição de fornecedor |
| Origem, impressões da conexão, sessão, sinais e limites | Cloudflare; Cloudflare sobre sinais; MaxMind; RFC 6585 | verificada como descrição das fontes; a aplicação a um site específico depende do caso |
| CAPTCHA pode criar barreiras de acessibilidade | W3C WAI | verificada |
| VPN e navegadores podem afetar classificações; frequência de falsos positivos | nenhuma fonte específica localizada sobre a frequência | não verificada; o texto afirma apenas que não localizamos uma taxa confiável |
| Razões entre páginas rastreadas e visitas de referência | Cloudflare | verificada como medição de fornecedor, não universal |
| Robots.txt não é mecanismo de autorização | RFC 9309 | verificada |
| Termos de Reddit, Google, OpenAI, Amazon Freight e GitHub | Reddit; Google; OpenAI; Amazon Freight; GitHub | verificada no escopo dos documentos, consultados em 16/11/2026; a aplicação a um caso concreto depende do caso |
| Art. 154-A, LGPD, Marco Civil e direitos autorais | Código Penal; LGPD; Marco Civil; Lei de Direitos Autorais | verificada quanto às normas; a aplicação concreta depende do caso |
| Decisões da ANPD sobre Meta em 2024 | Medida inicial; decisão posterior | verificada quanto aos atos de 2024; atualizações posteriores não verificadas |
| Projeto de lei 2338/2023 em tramitação | Câmara; Senado | verificada em 16/11/2026; revalidar no dia da publicação |
| Van Buren, hiQ e Meta v. Bright Data | Van Buren; hiQ; acordo hiQ; Meta v. Bright Data | verificada nos textos das decisões (Meta v. Bright Data de 23/01/2024; acordo hiQ de 08/12/2022, US$ 500 mil); desdobramentos posteriores não verificados; recurso e desistência em Meta v. Bright Data aparecem apenas em fonte secundária, não citada no texto |
| Exceções europeias, GDPR e AI Act | Diretiva 2019/790; AI Act; Comissão Europeia, perguntas e respostas; EDPB, parecer 28/2024 | verificada quanto aos textos; a aplicação concreta depende do caso |
| Acordos, identidade e cobrança por rastreamento | Guardian; Financial Times; Web Bot Auth; Cloudflare | verificada como anúncios e documentação; vigência e disponibilidade atuais não verificadas |
| Padrões em dez discussões públicas (custo e diagnóstico de quem coleta; consumo, desempenho e risco de falsos bloqueios para quem administra sites) | Coleta; administração de site; demais links no relatório interno de verificação, anexo | verificada: as dez páginas sustentam os padrões; relatos individuais, amostra não representativa |
| Método, finalidade e limites da skill de Gabriel | repositório privado de Gabriel, sem link público; análise e verificação em relatórios internos, anexos | verificada quanto ao material lido; sem teste executado; a skill não verifica termos de uso nem autorização |
| Resultados de categorias de contorno em serviços específicos | Cloudflare, mecanismos | não verificada em serviços específicos; nenhum teste foi executado e não há garantia de eficácia |
 Inteligência artificial